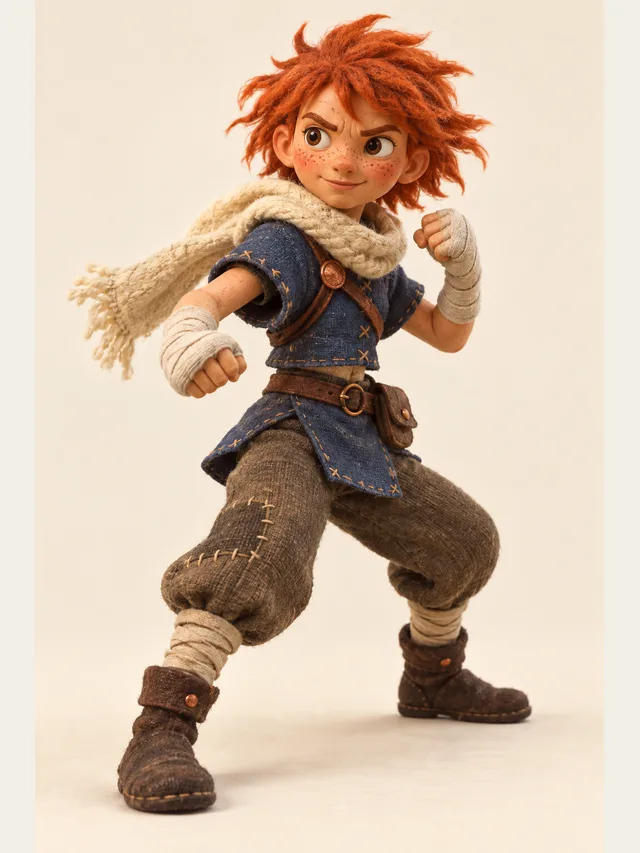
Aria
Bright shonen-anime lead who narrates her own fight scenes
zh-CN · 简体中文
На путунхуа играют все сорок персонажей, и несут их десять базовых голосов — те же, что в любом другом языке здесь. Внутри одного проекта двум персонажам не достаётся один и тот же голос, пока эта десятка не разобрана, поэтому состав до десяти расходится сам собой. На выходе стандартный путунхуа: тайваньского и региональных выговоров заказать нельзя, кантонского тоже. Впрочем, работа в китайском всё равно не здесь, а в том, чтобы каждое имя прочли тем чтением, которое вы имели в виду.
Aria
Bright shonen-anime lead who narrates her own fight scenes
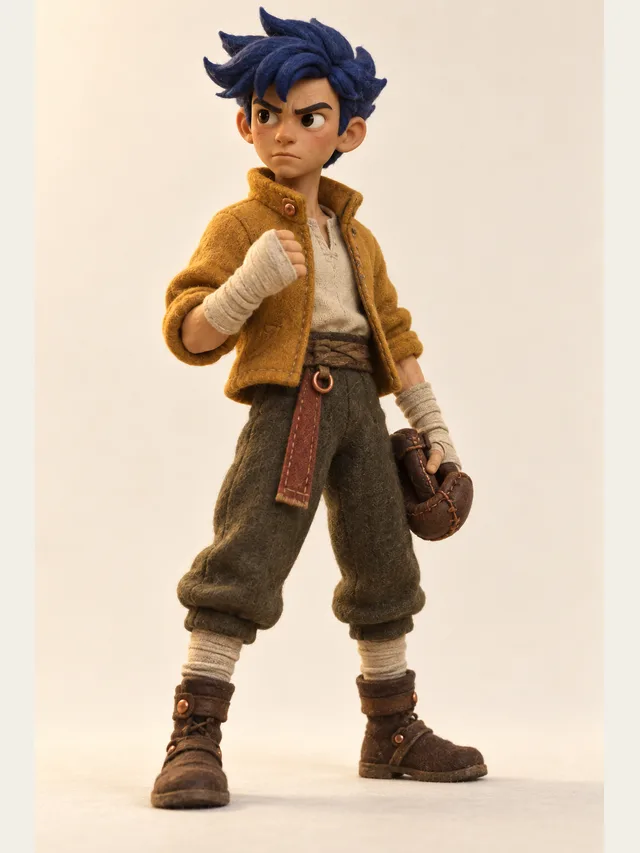
Koji
Rival character: clipped, competitive, secretly loyal
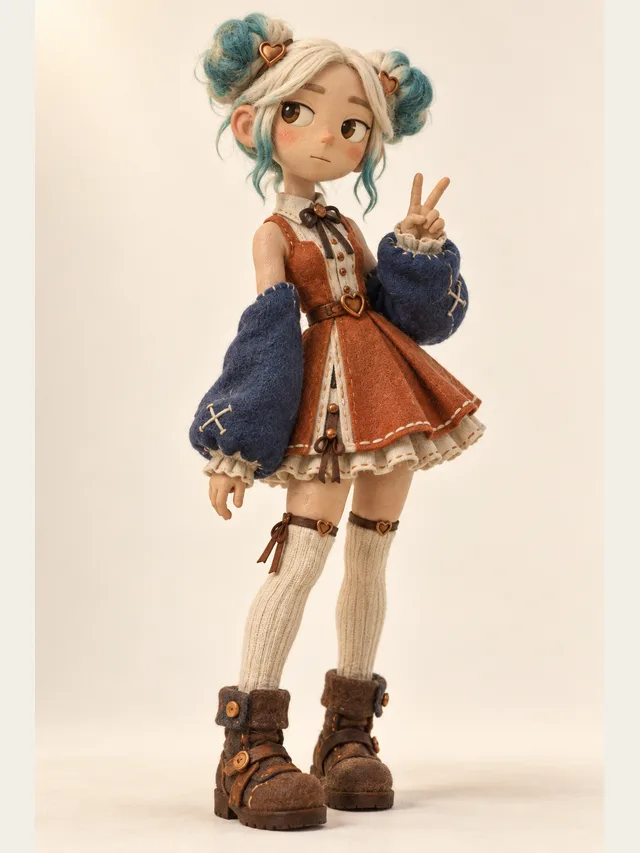
Lumen
VTuber persona: cute on top, deadpan underneath
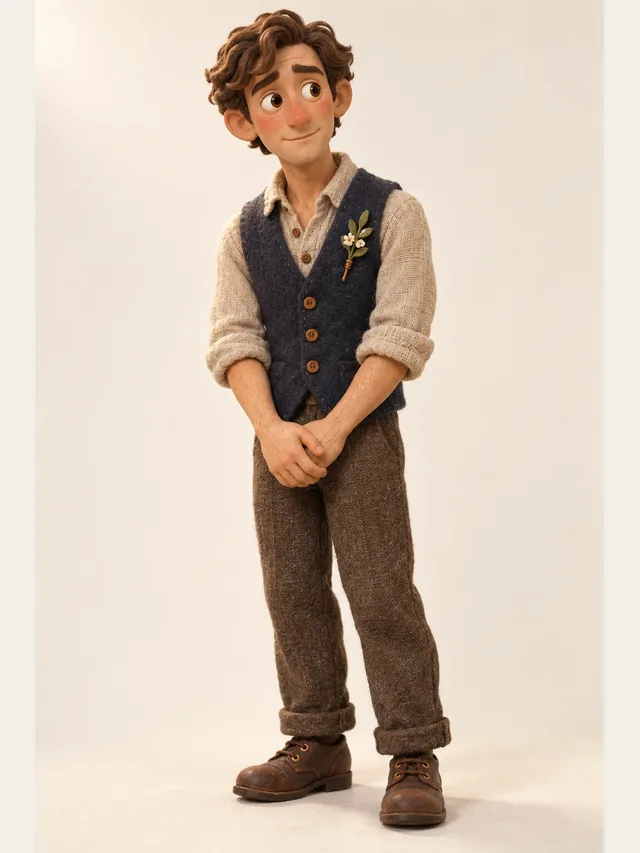
Ezra
Visual-novel love interest with a two-second pause before honesty
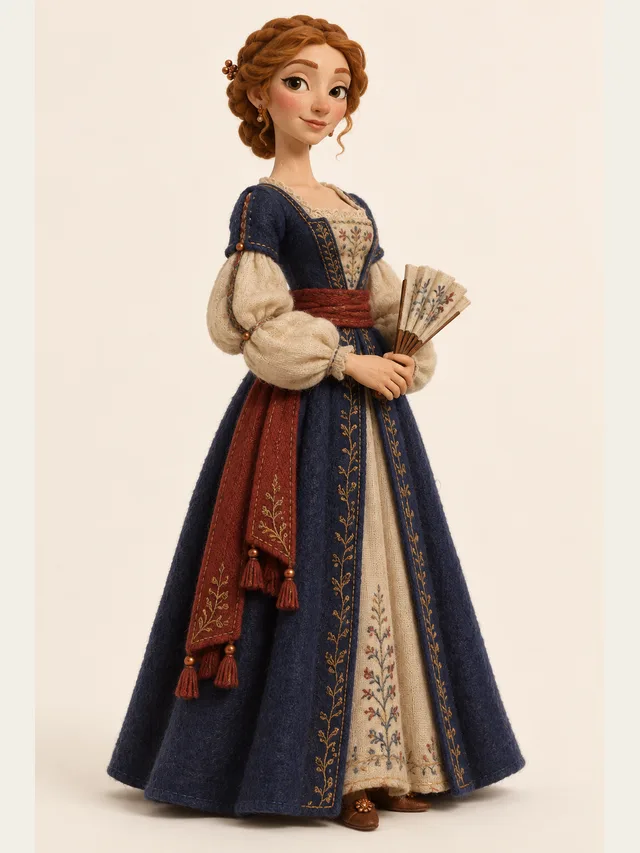
Seraphine
Court princess whose politeness is a weapon
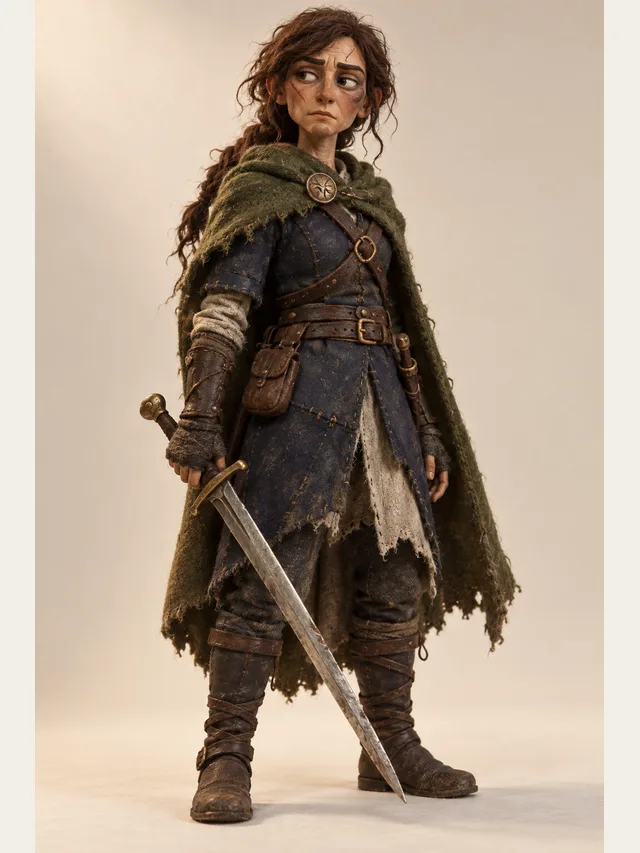
Kestrel
Low, weary swordswoman who has already lost this war once
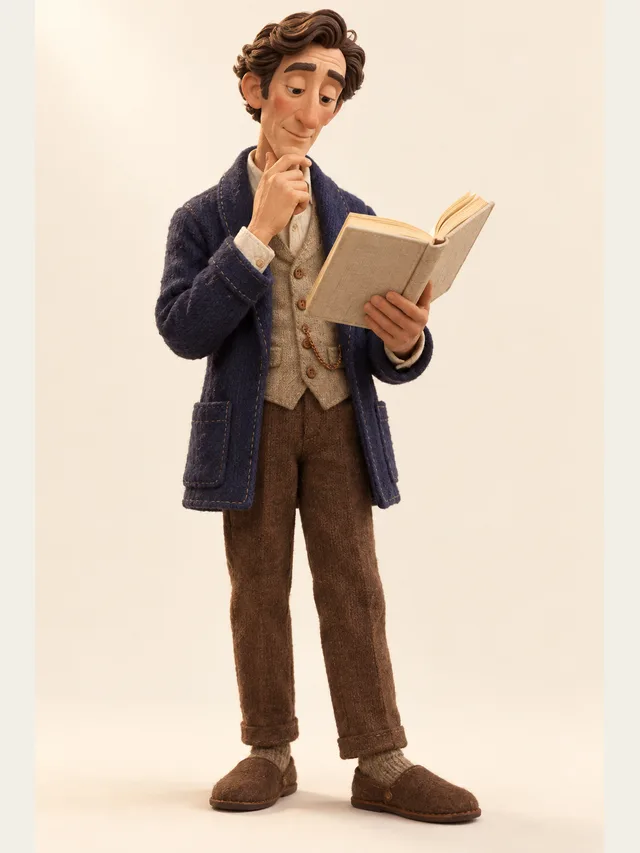
Dorian
Audiobook baritone for literary fiction and slow reveals
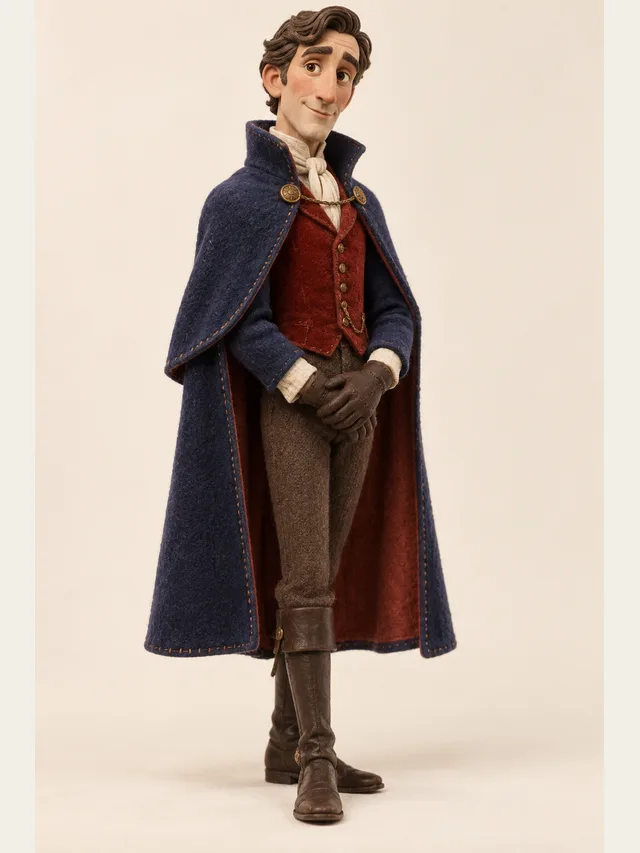
Ashford
Velvet-voiced villain who apologises before he ruins you
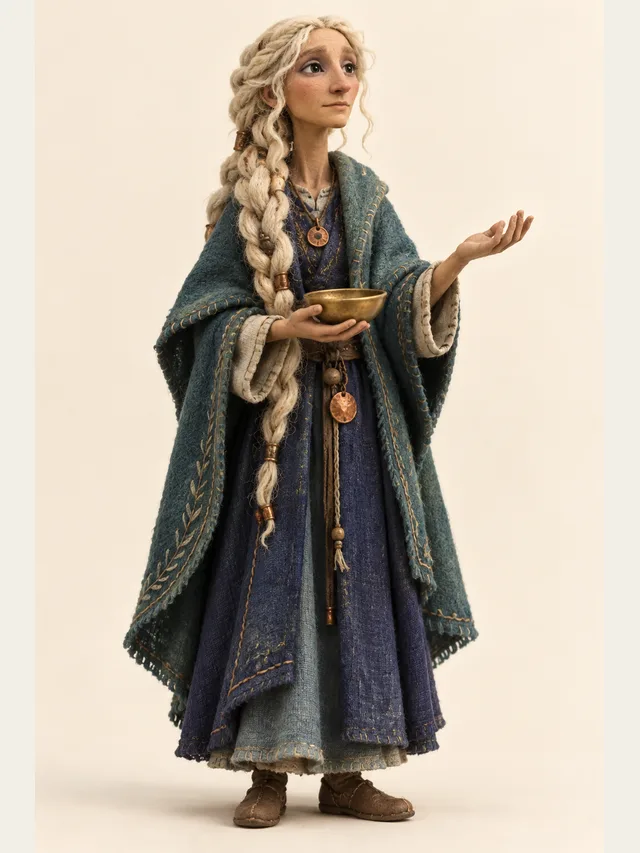
Delphi
Oracle who answers the question you should have asked
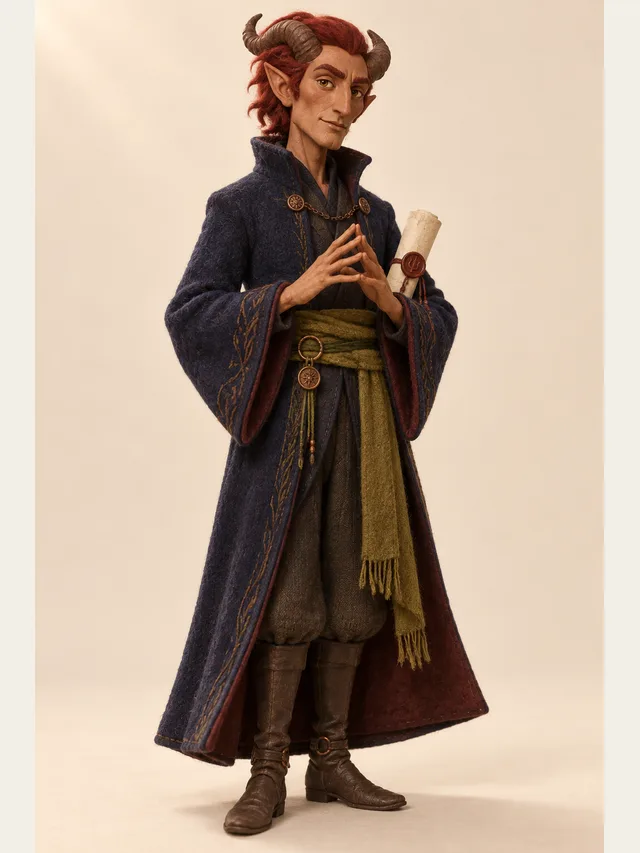
Vex
Demon who negotiates in a reasonable tone
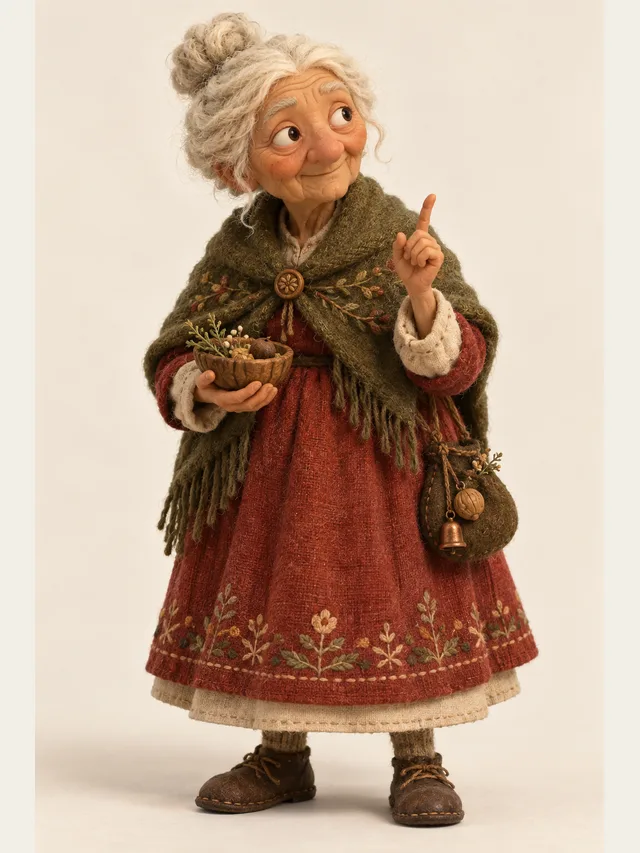
Gran Thea
Grandmother telling a folk tale she half believes
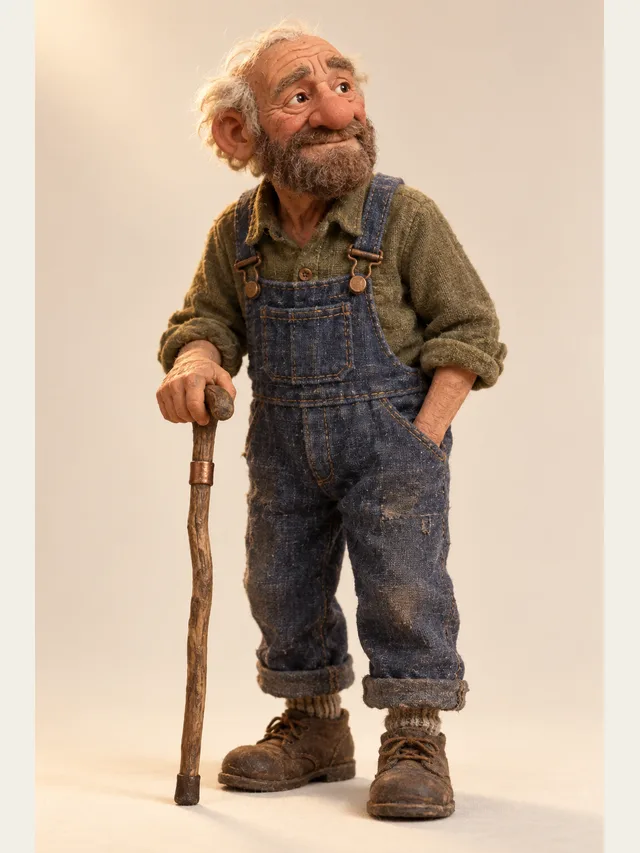
Orrin
Old man on a porch who remembers the flood
Все персонажи, их 40 — каждый играет на языке Китайский (упрощённый) →
Десять разных голосов закрывают то, что нужно обычной сцене, и не дотягивают до толпы. Распределение внутри проекта не выдаст двум персонажам один и тот же голос, пока не разобраны все десять, поэтому состав разводится сам и следить за этим не нужно. Ограничение начинает кусаться только на Plus и Pro: на Free в проекте два персонажа, на Basic — пять.
Порядок важен потому, что каждый персонаж библиотеки закреплён за одним из десяти. Когда второй персонаж проекта претендует на занятый голос, переезжает тот, кто добавлен позже, — сначала в пул своего пола, потом на общий, — а те, кто уже в проекте, остаются при своём. Значит, персонаж, добавленный на шестой неделе, не обесценивает отрендеренное аудио. Двоих на одном голосе разводит исполнение: возраст, темперамент и указание к каждой реплике; это настоящая разница, но меньшая, чем смена голоса. Поэтому соберите лист ролей до прослушивания и послушайте отдельно тех, кому пришлось переехать, вместо того чтобы верить описаниям.
Многочтимые иероглифы в китайском — обычное дело, и сгущаются они ровно там, где художественному тексту нужна точность: в именах. 单 — это Шань как фамилия и dān во всех прочих случаях; 解 — Се как фамилия и jiě иначе; 仇, 覃, 区 и 乐 ведут себя так же. Вне имён 行, 重 и 长 меняют чтение вместе со смыслом, и неверный выбор даёт другое слово, а не странную интонацию. Для русскоязычного автора тут есть отдельная ловушка: транскрипция Палладия к делу не относится — вставлять надо иероглифы, и решается всё на их стороне.
Списка исключений для чтений здесь нет, а фонетической записи наподобие японской каны в китайском нет вовсе. Зато есть омофоны: замените неверно прочитанный иероглиф другим — с тем же слогом, тем же тоном и единственным чтением, — и слушатель услышит нужное имя; напишите 善 вместо фамильного 单, и прозвучит Шань. Цена — в субтитрах: SRT на Plus и Pro идёт за текстом сценария, поэтому подменный иероглиф попадёт туда, и для релиза с субтитрами его придётся вернуть в своём редакторе. Прослушивайте каждое имя до того, как рендерить серию: именно там проблема и вылезает.
Сандхи третьего тона, 一, меняющее тон в зависимости от следующего слога, 不 перед четвёртым тоном — внутри фразы всё это обычно выходит верно. Ломается оно на границах, которые вводите вы: разрыв строки или запятая, поставленная в середину слова, отменяют сандхи, и 你好, прочитанное как два отдельных слога, носитель слышит мгновенно, хотя в тексте не опечатано ни одного знака.
Поэтому практическое правило для китайских сценариев обратно совету для большинства языков: не режьте реплики ради ритма. Держите каждое высказывание целым, а темпом занимайтесь построчным регулятором скорости на Plus и Pro — он меняет подачу, не меняя того, где, по мнению движка, кончаются слова.
Семь строк разговора о сроке сдачи, три говорящих, текст написан для этой страницы. Состав: LUMEN и KOJI — двое, которые спорят, ORRIN — старший, который спор гасит. Имена персонажей остаются латиницей: это названия ролей, а не часть китайского текста. Ремарок в скобках внутри реплик нет — скобка внутри произносимой строки будет прочитана вслух; ремарка отдельной строкой не звучит, а становится указанием к следующей реплике — его видно и можно поправить в списке реплик.
LUMEN: 「单老师说下周交。」 — Нейтрально. И сразу главная работа китайского сценария: 单 здесь фамилия и читается Шань, а не dān. Такие места слушают отдельной репликой и до того, как написана серия; если чтение не выправляется, ставят другой иероглиф с тем же слогом и тоном.
KOJI: 「他说的是这周。」 — Нейтрально. Логическое ударение несёт 的 в 说的是, и подчёркивать его пометкой не нужно: гнев здесь превратит спор в ссору на второй строке.
ORRIN: 「别吵了,问一句不就完了。」 — Нейтрально и на ступень медленнее; построчный темп есть на Plus и Pro. Обратите внимание на 一 в 问一句: перед слогом четвёртого тона оно меняет тон само, и ломается это ровно тогда, когда вы вставите разрыв или лишнюю запятую внутрь этой группы.
LUMEN: 「我问过了,他没回。」 — Нейтрально или грусть, на выбор: послушайте оба варианта на своём тексте, разница тоньше, чем кажется на бумаге.
KOJI: 「那就按这周做。」 — Нейтрально. 那就 — это уступка, и она слышна в словах; пометка её только перекроет.
ORRIN: 「按这周做,交早了也没人说你们。」 — Нейтрально, темп тот же, что в его первой реплике. Реплику не надо резать запятой ради ритма: запятая, поставленная внутрь слова, отменяет тональные изменения на стыке, и носитель слышит это мгновенно.
LUMEN: 「那就白熬一个晚上。」 — Грусть. Ключевое слово 白, и одна помеченная реплика в финале делает больше, чем пять по всей сцене. Итого одна-две пометки на семь строк; построчная эмоция доступна на Pro, а на других тарифах то же самое собирается эмоцией персонажа по умолчанию.
У русскоязычного автора в китайском есть собственный набор ловушек, и первая из них — привычка к транскрипции. Шесть проверок до длинного рендера.
Многочтимые иероглифы в именах. Как слушать: по одному имени, отдельной репликой, раньше всего прочего. Что считать проблемой: 单, 解, 区, 乐, 曾, 覃, прочитанные общим чтением вместо фамильного, — это другое слово, а не оттенок. Как чинить: списка чтений здесь нет, поэтому подставьте иероглиф с тем же слогом, тем же тоном и единственным чтением; в субтитрах SRT окажется подменный знак, и для релиза его придётся вернуть.
Транскрипция вместо иероглифов. Как слушать: строки, которые вы правили в спешке. Что считать проблемой: пиньинь или запись по Палладию, оставшиеся в произносимой реплике. Кириллица и латиница внутри китайского текста читаются ничем не заданным образом, и сверка записанного с текстом спотыкается о них чаще всего. Как чинить: только иероглифами.
二 и 两, и особый случай 一. Как слушать: реплики со счётом, номерами и датами. Что считать проблемой: 两个人 против 二十, а в номерах телефонов и комнат 一 читается как yāo. Как чинить: писать числа иероглифами там, где они произносятся, и прослушивать эти реплики отдельно.
Русские имена в иероглифах. Как слушать: по одному имени. Что считать проблемой: выбранная запись и есть произношение, поэтому имя, записанное неудачно, неузнаваемо, и другого рычага нет. Как чинить: перепробовать два-три варианта и выбрать на слух.
Пунктуация и место разрыва. Как слушать: самую длинную реплику целиком. Что считать проблемой: запятая или разрыв строки посреди слова — тональные изменения на стыке отменяются, и 你好, прочитанное двумя отдельными слогами, слышно носителю сразу, хотя в тексте ни одной опечатки. Как чинить: держите высказывание целым и пользуйтесь полноширинной пунктуацией, а темпом занимайтесь построчным регулятором на Plus и Pro.
Латиница и аббревиатуры внутри китайской реплики. Как слушать: строки с латинскими буквами. Что считать проблемой: аббревиатура, прочитанная не так, как вы рассчитывали, или строка, вернувшаяся ошибкой. Как чинить: разверните её китайскими словами.
Язык проекта берётся из языка интерфейса CastDub в момент создания и остаётся. Это же не даст прочитать японский или корейский текст китайскими чтениями общих иероглифов.
Распределение избегает повторов по всему проекту, поэтому голос персонажа зависит от того, кто уже в составе. Соберите полный лист ролей сразу — и никого не придётся переслушивать.
Каждую фамилию и каждое выдуманное имя, до того как рендерить что-то длинное. Там, где чтение не выправляется, подставьте иероглиф с тем же слогом и тоном.
Не ломайте реплику посреди фразы ради ритма. Вместо этого пользуйтесь построчным регулятором темпа на Plus и Pro.
Сведённый MP3 на любом тарифе, SRT начиная с Plus, отдельные дорожки по персонажам — на Pro.
Десять. На путунхуа играют все сорок персонажей, а распределение внутри проекта избегает повторов, пока эта десятка не кончится, так что столько говорящих и могут звучать по-настоящему по-разному одновременно. Это те же десять, что во всех девяти языках сайта.
Нет. Распределение идёт в порядке добавления: все, кто уже в проекте, остаются при своих голосах, а переезжает при совпадении новичок. Так сделано намеренно — перетасовка молча обесценила бы уже отрендеренное аудио.
Нет. Кантонский — отдельный разговорный язык, а не настройка акцента, и письменный кантонский тоже другая орфография. Кантонский текст, вставленный в проект на путунхуа, кантонским не зазвучит.
Отдельной настройки для этого нет — списка чтений не существует. Прослушивайте имена заранее, а там, где иероглиф прочитан неверно, подставляйте другой с тем же слогом, тем же тоном и единственным чтением: слушатель услышит нужное имя, хотя в субтитрах SRT будет стоять подменный иероглиф.
Нет, вставлять надо иероглифы. Транскрипция по Палладию — инструмент для русского текста о Китае, а не для китайского сценария, и в произносимой реплике она бесполезна: кириллица и латиница внутри китайского текста читаются ничем не заданным образом, а сверка записанного с текстом спотыкается о них чаще всего, так что строка может вернуться ошибкой. То же касается пиньиня, включая пиньинь с цифрами тонов. Всё, что должно прозвучать, пишите иероглифами, а транскрипцию держите в своих рабочих заметках.
Подобрать иероглифы на слух. Выбранная запись и есть произношение — отдельной настройки чтения здесь не существует, поэтому перепробуйте два-три варианта одного имени, прослушайте их отдельными репликами и оставьте тот, который узнаётся. Делать это надо до длинного рендера: имя главного героя звучит в серии десятки раз, и менять его потом дороже всего. Если у имени есть устоявшаяся китайская запись, начните с неё, но всё равно послушайте: устоявшаяся не значит совпадающая с тем, как вы его слышите.
Вставьте сценарий, дайте CastDub подобрать голос каждому персонажу и экспортируйте готовый аудиоспектакль.
Создать бесплатноКарта не нужна. Free даёт разовый запас кредитов.