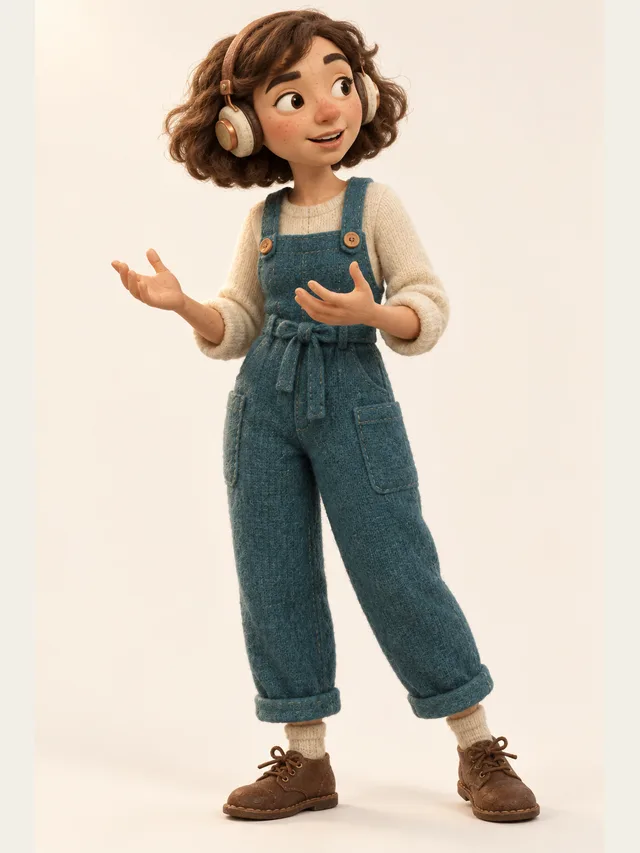
Juno
Ведущая, которая думает вслух
Категория голосов
Сценарный подкаст — формат, которому синтетические голоса подходят лучше всего: всё написано заранее, воспринимается только на слух и делается обычно одним-двумя людьми без студии. Подберите ведущих, подберите гостя, отрендерите выпуск.
Juno
Ведущая, которая думает вслух
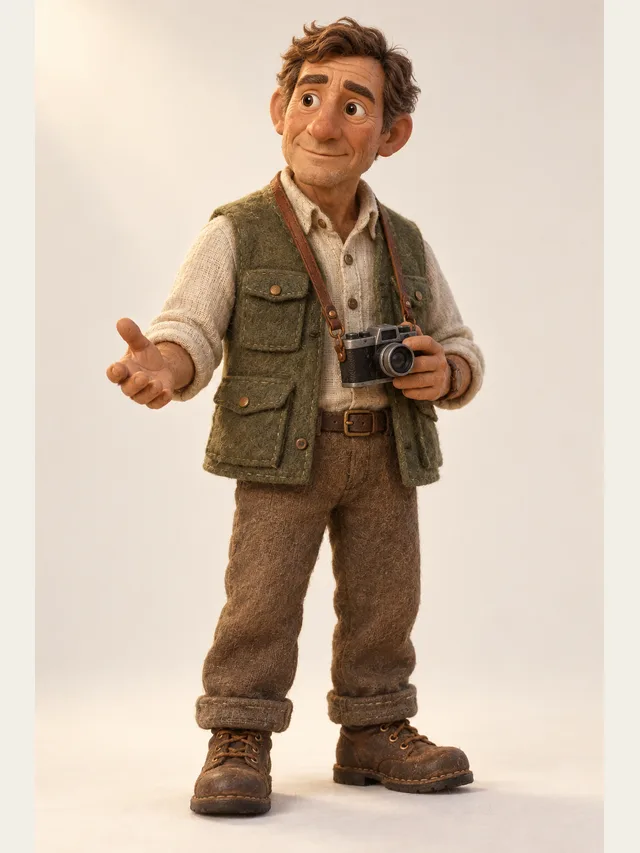
Hale
Рассказчик для документальных вставок
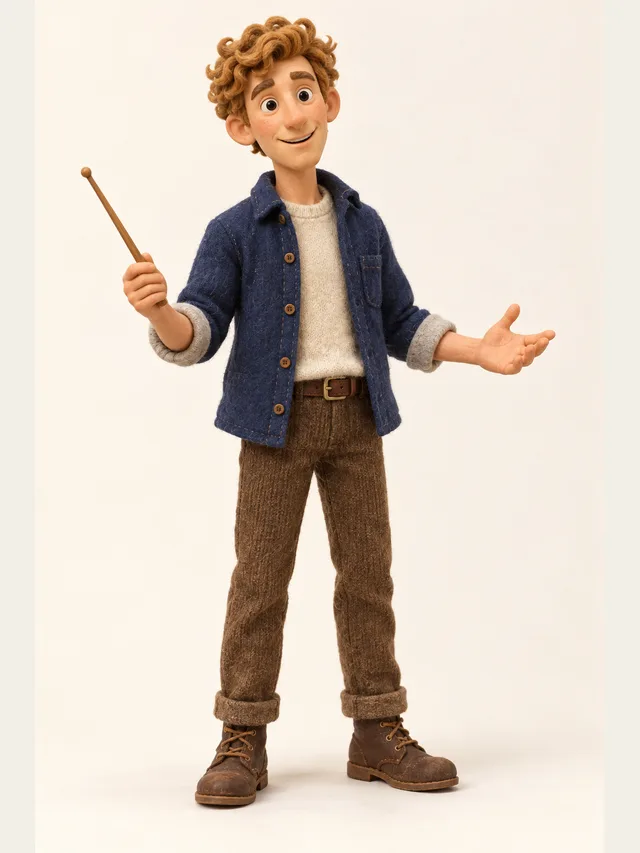
Quill
Соведущий, которому никогда не скучно
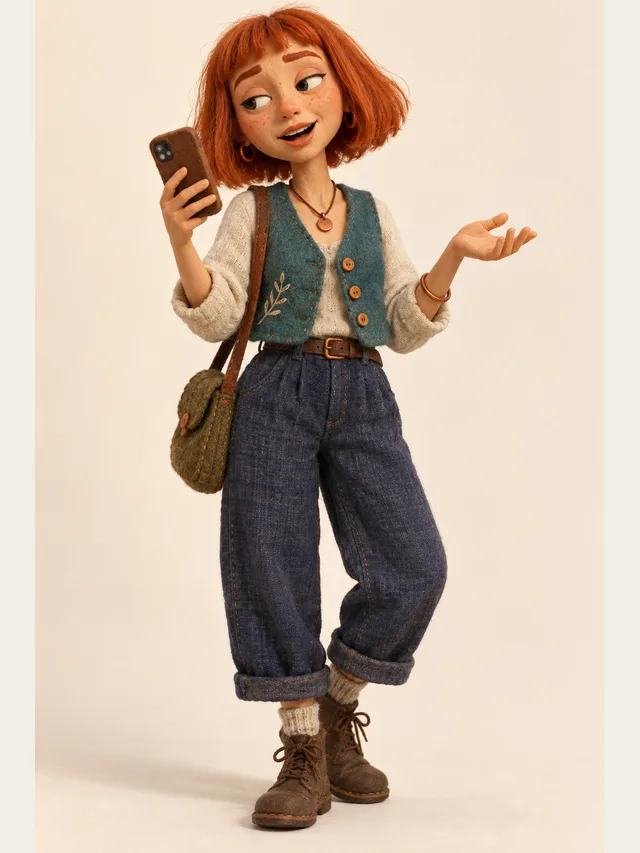
Indie
Быстро, ровно, с лёгкой усмешкой
Каждый голос доступен на любом тарифе: библиотека не платная стена.
Без регистрации. Напишите одну реплику, выберите, кто её произносит, и послушайте.
Подкастинг делится примерно надвое: разговорные шоу, где двое говорят без сценария, и сценарные, где каждое слово написано заранее. Для первых синтетические голоса почти бесполезны, для вторых по-настоящему хороши, потому что сценарное шоу — это и есть исполнение написанного текста, а именно этим такие инструменты и занимаются.
Внутри сценарного подкастинга лучше всего ложатся нарративная художественная проза и документальное повествование. В русскоязычном подкастинге это как раз выросшие жанры: исторические сериалы, тру-крайм с реконструкциями, аудиосериалы по оригинальным сценариям. У всех есть рассказчик, держащий структуру, и персонажи или говорящие внутри неё, — что в точности ложится на схему «распределить роли и отрендерить».
Разница между расшифровкой живой речи и написанным диалогом видна на бумаге: в настоящей речи есть фальстарты, повторы слов, слова-заполнители и предложения, обрывающиеся раньше конца. Написанный диалог опрятен. Когда опрятный текст исполняют, это звучит как исполнение — что нормально для драмы и неверно для разговорного подкаста.
Лечится это тем, что неопрятность надо написать. Вынесите «да нет, я о другом» на бумагу. Дайте соведущему короткие вставки отдельными репликами. Оборвите предложение и дайте другому его закончить. Никакой функции для этого не нужно — нужно решение это написать.
Данные о прослушивании одинаковы на всех площадках: самые большие отвалы приходятся на первые полторы минуты и на границы блоков. Отсюда две структурные привычки. Начинайте с содержания, а не с длинной фирменной заставки, и делайте так, чтобы каждый переход что-то делал: вопрос, крючок, смену голоса.
Смену голоса недооценивают как инструмент внимания. Переход от ведущего к рассказчику или появление нового персонажа перезапускает внимание так, как не сделает никакая энергия внутри одного голоса. Состав даёт вам этот рычаг на каждой границе блока.
Аудитория подкастов необычно привязана к ведущим — именно поэтому нераскрытые синтетические ведущие плохо кончают, когда их вычисляют. Поставьте строку в описании. Это ничего не стоит и переводит разговор из плоскости обмана в плоскость ремесла.
Есть один абсолютный предел: не генерируйте голос, похожий на реального опознаваемого человека, и не выдавайте его за него. Это выдача себя за другого независимо от намерения и самый быстрый способ потерять и шоу, и аккаунт.
Аналитика подкастов безжалостно однообразна: крупнейший единичный отвал приходится на первые полторы минуты, а длинная фирменная заставка в начале выпуска — самый надёжный способ его устроить. Удерживает структура «сначала содержание»: полминуты самого интересного, что есть в выпуске, потом заставка, потом основная часть.
Для сгенерированного шоу это важнее, чем для записанного, потому что у синтетического голоса меньше той побочной теплоты, которая живому ведущему покупает несколько секунд доверия. Внимание придётся заработать текстом, а не обаянием.
Сгенерированный диалог приходит чистым и ровным — звучит как преимущество и создаёт одну конкретную проблему: он лежит поверх музыкальной подложки, а не внутри неё. Лечится это тем же, чем лечится в эфире десятилетиями: подложку приглушают под речью, а под диалог добавляют совсем немного тона комнаты, чтобы он занимал пространство, а не парил.
И то и другое — разовые решения, которые сохраняются шаблоном. Один раз настроили — и каждый следующий выпуск ложится правильно без размышлений, а это именно та задача, которую стоит решить однажды.
Подкаст на двух ведущих — это разговор с перебиваниями, поддакиванием и недоговорёнными фразами. Статья, разделённая на два голоса, звучит ровно как статья, разделённая на два голоса.
Ведущих нужно различать внутри одного предложения, потому что лиц у слушателя нет. Берите разные высотные полосы и разную скорость речи.
Холодное начало, заставка, содержательные блоки, финал. Заново генерируются только изменённые реплики, так что середину можно переделывать, не трогая верх, — а если блоки нужны отдельными файлами, заведите на каждый свой проект.
Внимание в подкасте падает равномерно. Ставьте самую энергичную подачу на стыки блоков, где слушатель решает, оставаться ли.
На Pro возьмите дорожки по голосам, чтобы заставка, отбивки и подложка встали под речь, а не дрались со сведённым файлом.
Часть заметит, особенно в форматах, которые притворяются незаписанным разговором: там выдаёт вылизанность. Нарративные и документальные форматы прячут это гораздо лучше, потому что слушатель и ожидает читки по сценарию. Указать это в описании выпуска и честнее, и, по нашему опыту, безболезненнее, чем быть пойманным.
В основном текстом. Разговорные частицы, написанные фальстарты, короткие перебивания и поддакивание отдельными репликами дают больше, чем любые настройки. Проблема «звучит как зачитанная статья» — проблема сценария, а не голоса.
Да, в аудиоредакторе, и это частая схема: ведущий — вы, соведущий или архивные персонажи — сгенерированы. Записывайтесь на похожем уровне и в достаточно заглушенной комнате, и они лягут вместе нормально.
Сгенерировать фальшивое интервью с реальным человеком нельзя, наши правила это запрещают. Интервью с вымышленным персонажем или явно обозначенная историческая реконструкция — пожалуйста.
Длина ограничена не рендером, а вашими месячными кредитами — знаками сценария, которые считаются при каждом экспорте: на Basic — 60 минут в месяц, чего хватает еженедельному пятнадцатиминутному выпуску, на Plus — 200, и это закрывает большинство еженедельных форматов.
Строго говоря нет, но с ней переходы гораздо понятнее, а синтетическому диалогу полезна фактура. Короткая отбивка между блоками заодно прикрывает стыки отдельно отрендеренных кусков.
Вставьте сценарий, дайте CastDub подобрать голос каждому персонажу и экспортируйте готовый аудиоспектакль.
Создать бесплатноКарта не нужна. Free даёт разовый запас кредитов.