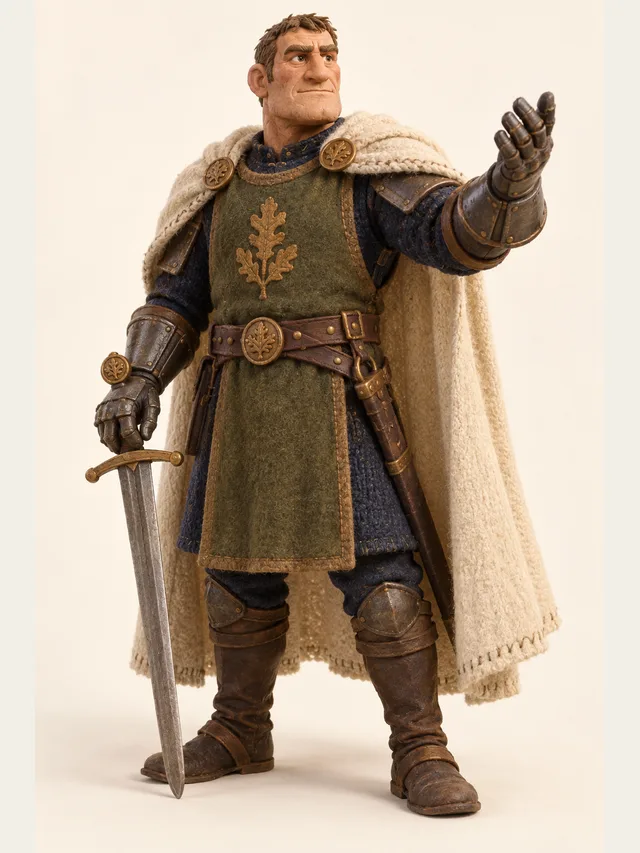
Torvald
Knight commander who gives orders that men actually follow
Продукт
Это и есть продукт. Всё остальное на сайте — двери в него. Вы приносите сценарий, где говорит не один человек; CastDub разбирается, кто они, даёт каждому исполнителя и выдаёт вам те же рычаги, которыми пользуется режиссёр.
Torvald
Knight commander who gives orders that men actually follow
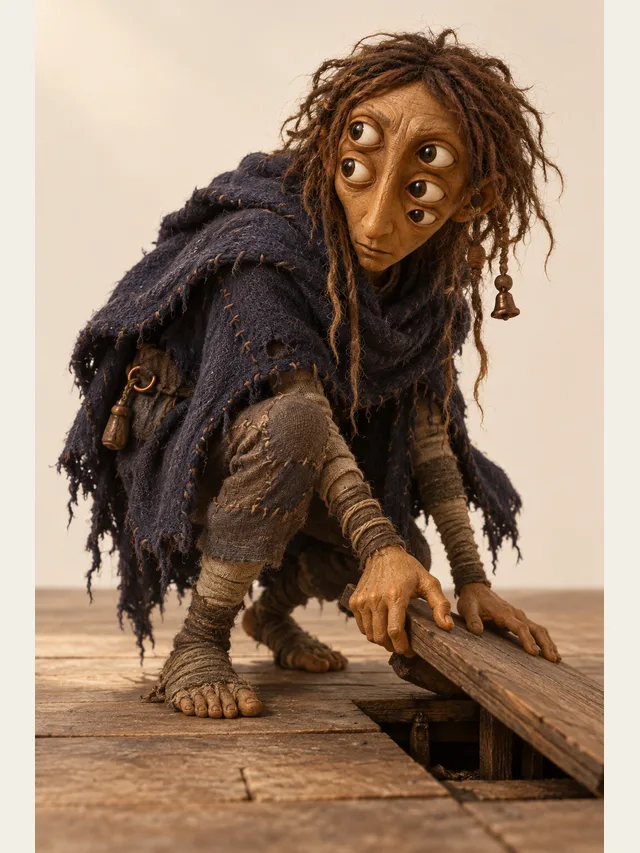
Morrow
Something under the floorboards that learned your name
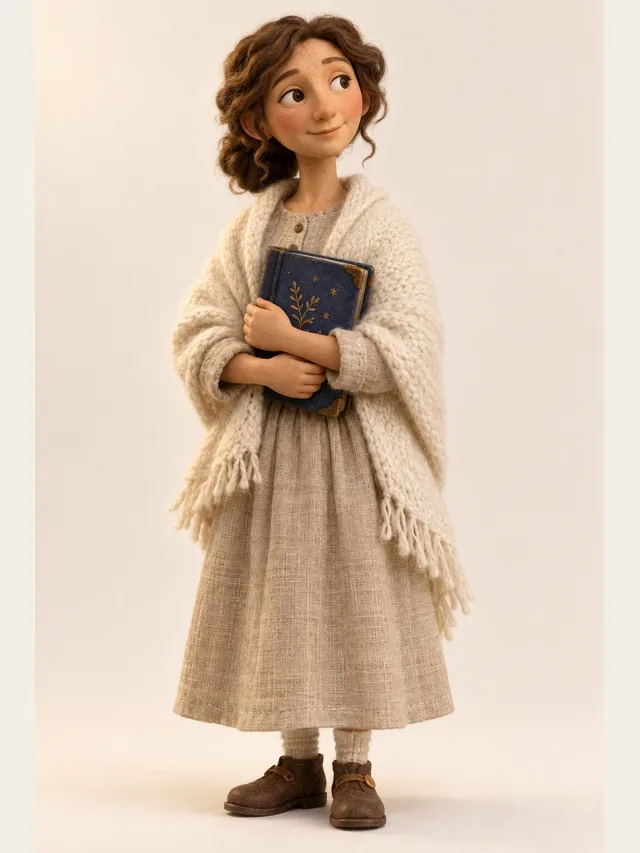
Wren
Bedtime-story narrator, slow and warm, never wakes anyone up
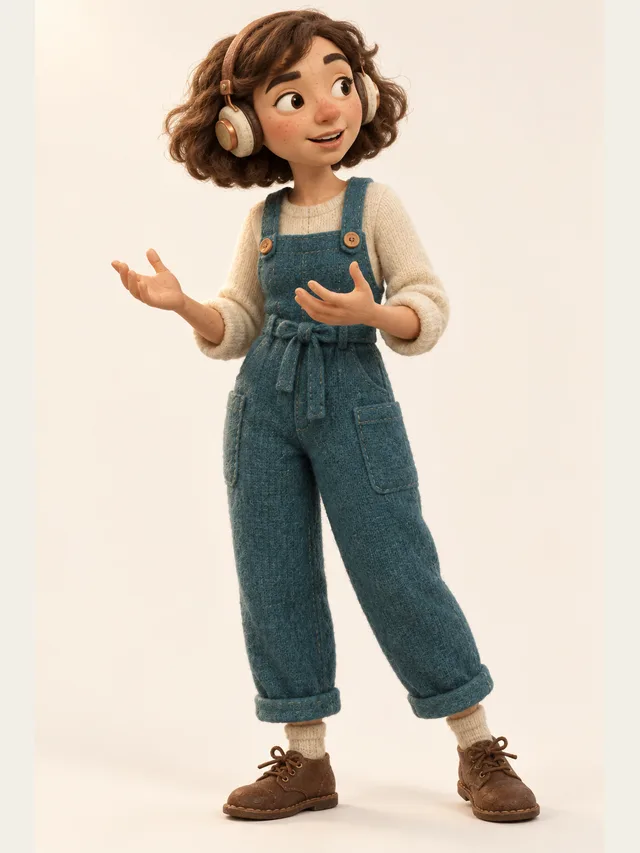
Juno
Podcast host who thinks out loud and never reads a script
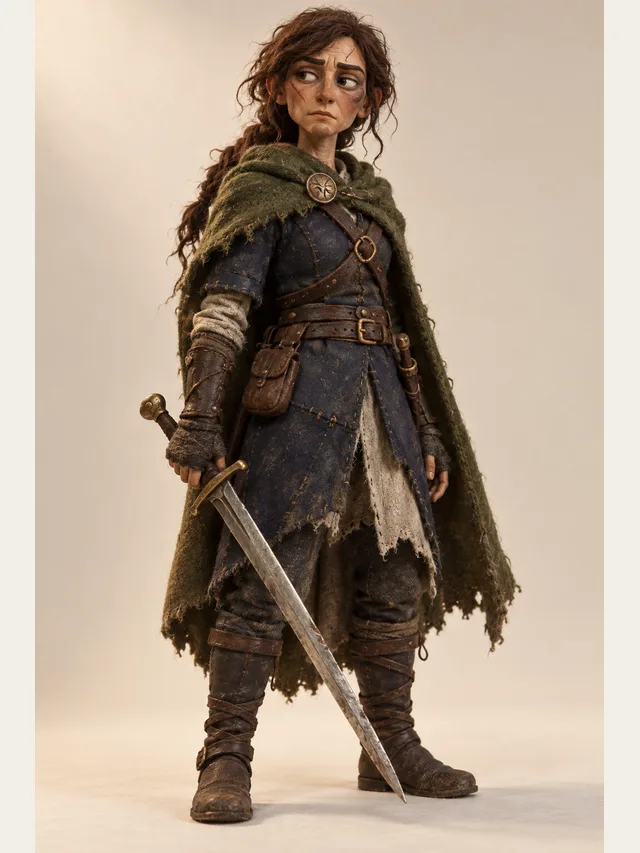
Kestrel
Low, weary swordswoman who has already lost this war once
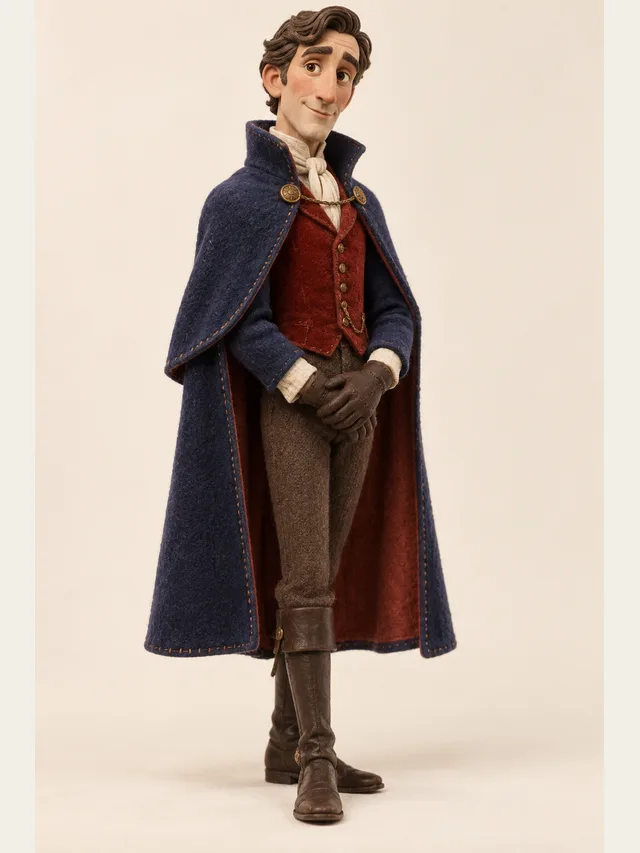
Ashford
Velvet-voiced villain who apologises before he ruins you
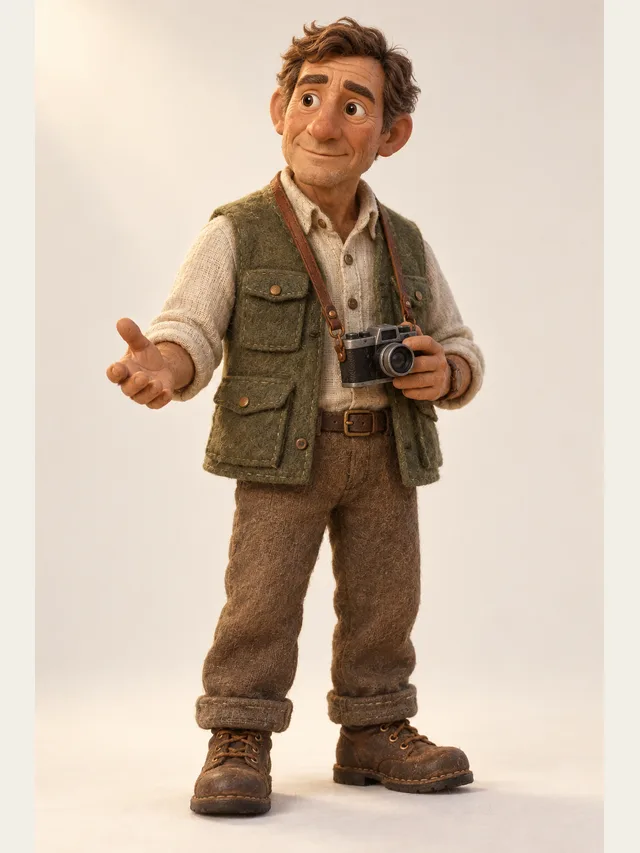
Hale
Documentary narrator with a hand on the listener's shoulder
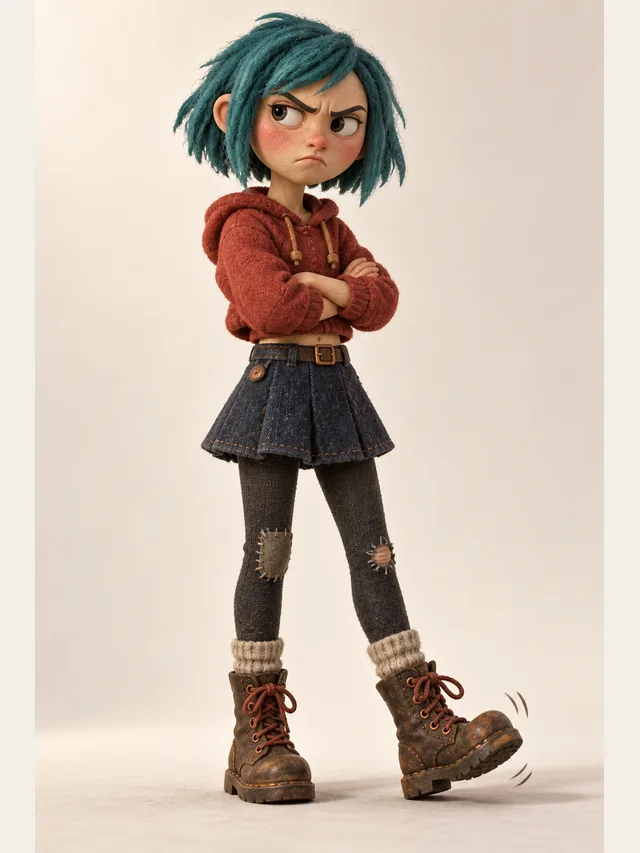
Cass
Seventeen and furious about it, in a good way
Формат киносценария, строки с префиксом «Имя:» и обычная проза с атрибуцией диалогов разбираются как есть. Вставляйте из документа, из программы для сценариев или из колонки таблицы. Загрузки файлов нет: .txt, .docx и .srt не импортируются, поэтому скопируйте текст и вставьте его.
Определение говорящих делит сценарий по тому, кто произносит реплику, а затем предлагает каждому говорящему персонажа из библиотеки — исходя из того, каким его показывает сценарий. Это предложение, а не решение: любое назначение можно изменить, и правка сохранится до конца проекта.
Эмоция — свойство реплики, а не персонажа. Задайте персонажу обычный регистр и отметьте только те реплики, где он ломается. Это единственный механизм, отличающий читку от игры, и это главное, что добавляет Pro: на остальных тарифах каждая реплика идёт с обычным регистром своего персонажа.
Имя, характер, пол, возрастная группа, персонаж из библиотеки и эмоция по умолчанию задаются один раз внутри проекта. Два персонажа одного проекта не делят голос, пока не кончится пул: базовых голосов десять — четыре женских, пять мужских и один нейтральный, — и больше десяти различных голосов в одном проекте не звучит ни на одном языке. Новый персонаж, добавленный позже, остальных не перетасовывает. Между проектами персонажи не переносятся, поэтому в сериале в каждой серии снова выбирают тех же персонажей из библиотеки.
Поправьте реплику — и заново синтезируется только она; всё остальное сохраняет уже готовое аудио. В длинном проекте это разница между свободной правкой и страхом перед каждой переделкой: три изменённые реплики стоят трёх реплик генерации, а не полного перерендера.
Сведённый MP3 на любом тарифе, отдельные дорожки по персонажам в ZIP на Pro для музыки и звукового дизайна и SRT начиная с Plus, сделанный из вашего сценария, а не расшифрованный с аудио, — поэтому имена написаны верно, а тайминги уже совпадают.
Скопируйте его как текст. Никакого переформатирования, никакого шаблона.
Посмотрите предложенный голос для каждого персонажа, прослушайте варианты на одной и той же реплике и зафиксируйте подходящий.
Дайте каждому персонажу эмоцию по умолчанию. Большая часть сцены идёт на умолчаниях.
Отметьте те реплики, где регистр ломается, — обычно три-пять на сцену.
Проблемы с темпом не видны по отдельным репликам и очевидны при сквозном прослушивании.
Микс, дорожки или субтитры — смотря куда аудио пойдёт дальше.
Синтез речи стал товаром широкого потребления. Несколько поставщиков выдают аудио, которого достаточно для драмы, и разрыв между ними меньше, чем разрыв между хорошо и плохо собранным составом. Товаром не стало всё, что вокруг синтеза: понять, кто говорит, удержать персонажа месяцами, отрежиссировать отдельные реплики и вынуть аудио в пригодном для сведения виде.
Поэтому слой поставщика здесь — интерфейс с несколькими реализациями. Если в следующем году появится движок получше, это станет изменением конфигурации, а не переписыванием, и ваши проекты, распределение ролей и режиссура реплик перейдут без изменений.
Он не пишет сценарии. Сгенерированные диалоги, сыгранные сгенерированными голосами, — продукт, который никто не просил дважды; интересная задача в аудиоспектакле лежит в производстве, а не в идеях.
Он не сводит. Ни музыкальных подложек, ни реверберации, ни расстановки по стерео. Это дело звукового редактора, где слышно всё вместе; попытки завернуть сведение в инструмент рендера стабильно давали результат хуже обоих.
Он не накладывает реплики друг на друга в одном рендере. Говорить поверх другого — настоящий драматургический приём, и это операция сведения: выгрузите дорожки и сдвиньте их. Одно движение в любом редакторе — и это самое достоверное, что можно сделать со ссорой.
Физическая вокализация — текущий предел: крик, рыдание, смех во время речи, кряхтение от усилия. Это события дыхания, а не речи, и именно на них слушатель опознаёт аудио как сгенерированное. Где можно — обойдите их в тексте; где нельзя — запишите те две-три реплики живьём. Смешивать записанное и сгенерированное в одной постановке нормально — это делается в аудиоредакторе, потому что записи в проект добавить нельзя, — и шва не слышно, когда момент держится на письме.
Второе слабое место — очень длинные эмоциональные монологи, по смежной причине: живой исполнитель принимает решение о подтексте каждые несколько секунд, а здесь этого никто не пытается делать.
Никакие — загрузки файлов нет. Вставьте сам текст: в формате киносценария, строками вида «Имя:» или прозой с атрибуцией диалогов. Из документа Word или файла субтитров скопируйте текст и вставьте его.
В сценарных форматах — почти всегда. В прозе зависит от того, насколько явная у вас атрибуция: длинные обмены репликами без указания говорящего и персонажи, названные по эпитету, — надёжные места сбоя. Просмотреть назначения перед рендером занимает минуту.
Да, и именно эта возможность делает длинные проекты выполнимыми. Поменяли реплику — перерендерили её, всё остальное сохраняет своё аудио.
Нет. Персонаж существует только внутри своего проекта. Для сериала создавайте новый проект на каждую серию, выбирайте тех же персонажей из библиотеки и пишите те же описания характеров. Тот же голос в другом проекте не гарантирован: голоса разводятся в порядке добавления персонажей внутри каждого проекта, — поэтому перед экспортом прослушайте первую реплику главного героя.
Здесь — нет. Выгрузите дорожки и озвучьте их в аудиоредакторе. Это намеренная граница, а не нехватка функции.
Только Pro. На Free, Basic и Plus каждая реплика идёт с эмоцией персонажа по умолчанию: этого хватает, чтобы проверить, работает ли сцена, но не чтобы поставить конкретный перелом на конкретную реплику.
Вставьте сценарий, дайте CastDub подобрать голос каждому персонажу и экспортируйте готовый аудиоспектакль.
Создать бесплатноКарта не нужна. Free даёт разовый запас кредитов.