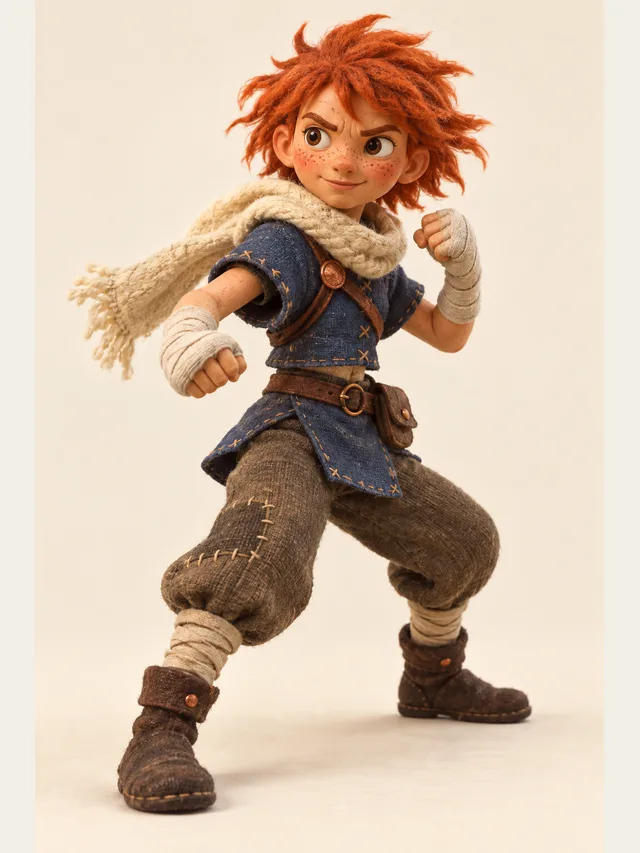
Aria
Bright shonen-anime lead who narrates her own fight scenes
zh-CN · 简体中文
40명 전부가 표준 중국어로 연기하고, 그 뒤에는 기본 보이스 열 개가 있어요. 아홉 개 언어에서 같은 열 개고요. 한 프로젝트에서는 그 열 개가 찰 때까지 두 인물이 같은 보이스를 받지 않아서, 열 명까지의 배역표는 저절로 갈라져요. 나오는 건 표준 중국어예요. 대만식 말씨나 지역 억양은 주문할 수 없고 광둥어도 없어요. 어차피 중국어에서 품이 드는 건 다른 데예요. 모든 이름을 당신이 의도한 음으로 읽히게 만드는 일이요.
Aria
Bright shonen-anime lead who narrates her own fight scenes
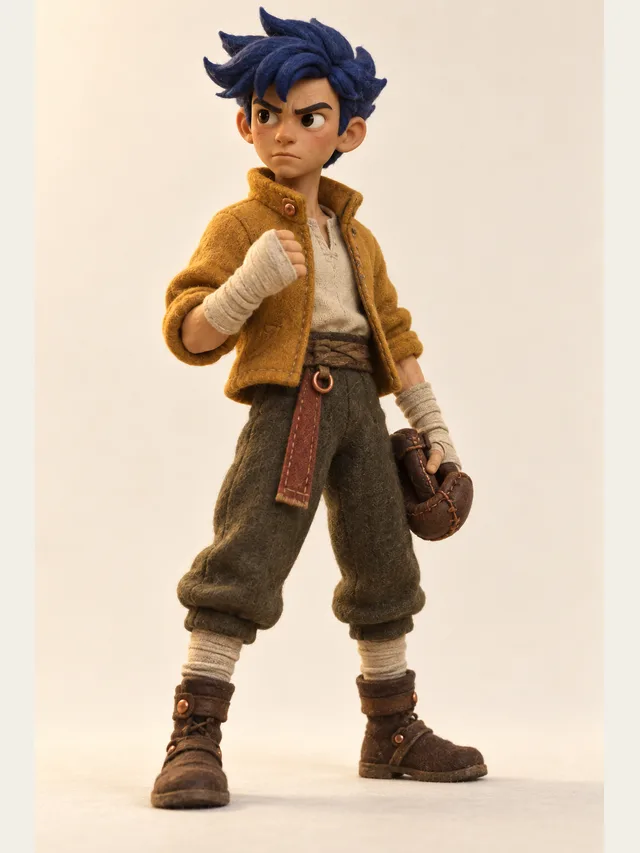
Koji
Rival character: clipped, competitive, secretly loyal
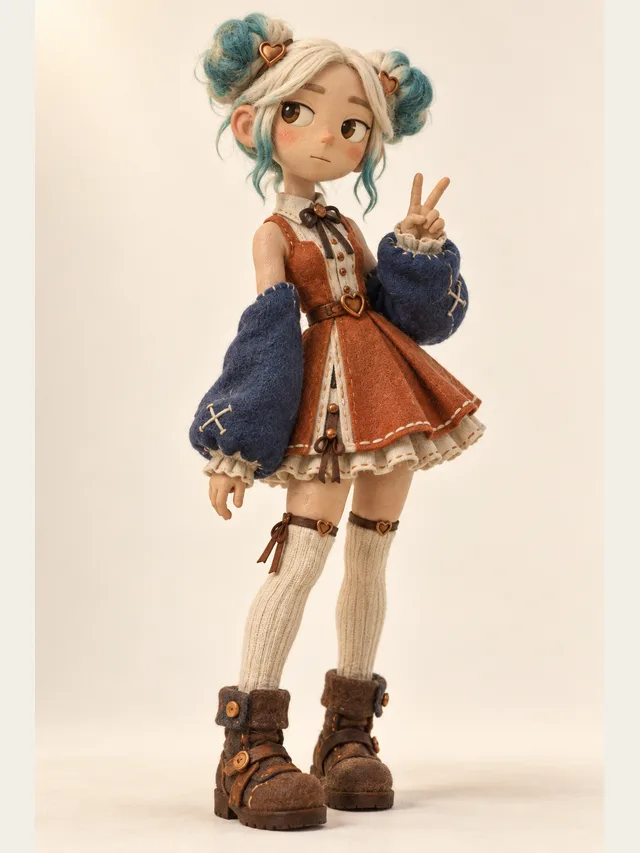
Lumen
VTuber persona: cute on top, deadpan underneath
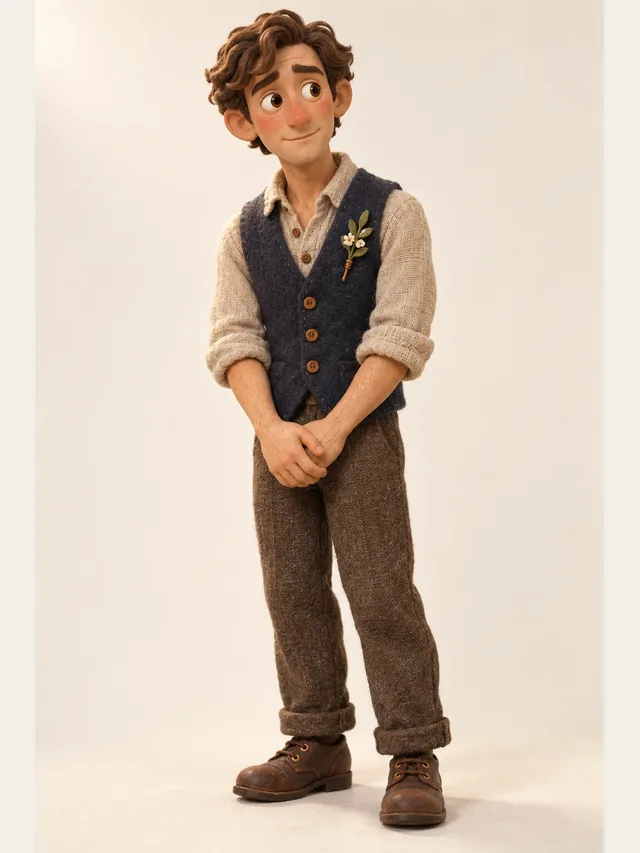
Ezra
Visual-novel love interest with a two-second pause before honesty
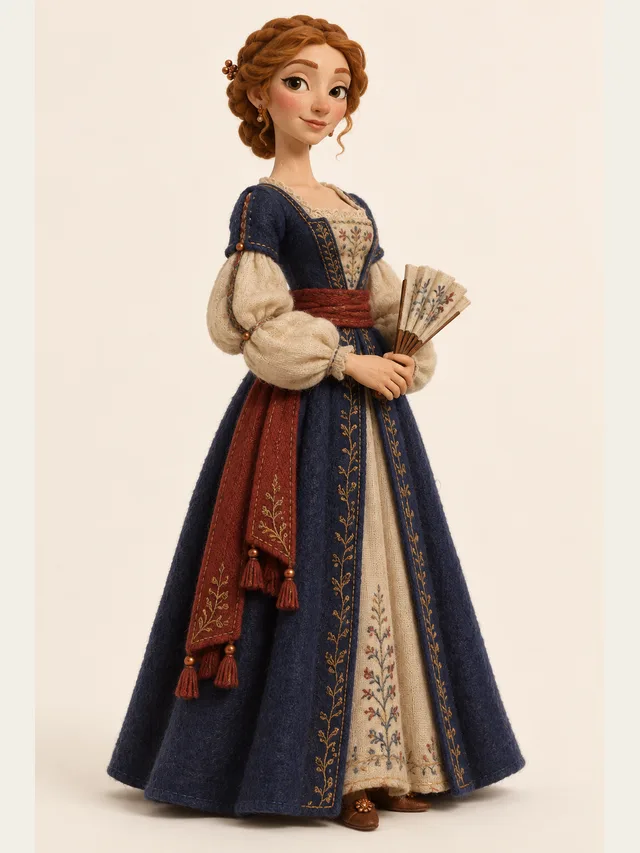
Seraphine
Court princess whose politeness is a weapon
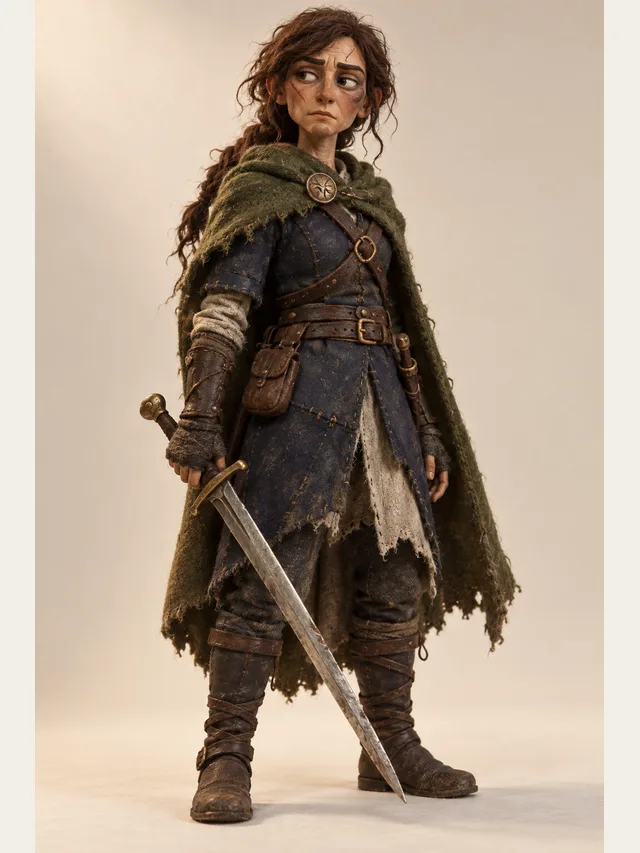
Kestrel
Low, weary swordswoman who has already lost this war once
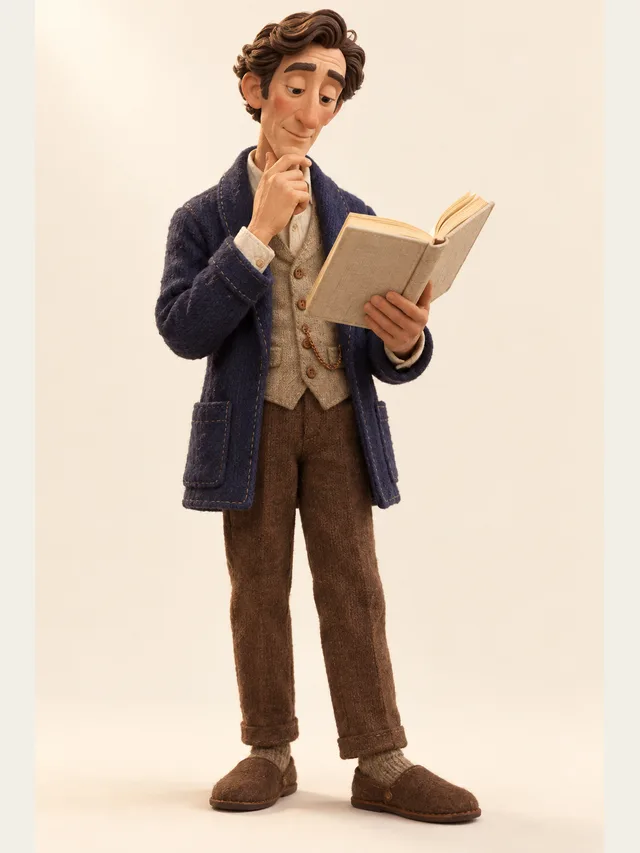
Dorian
Audiobook baritone for literary fiction and slow reveals
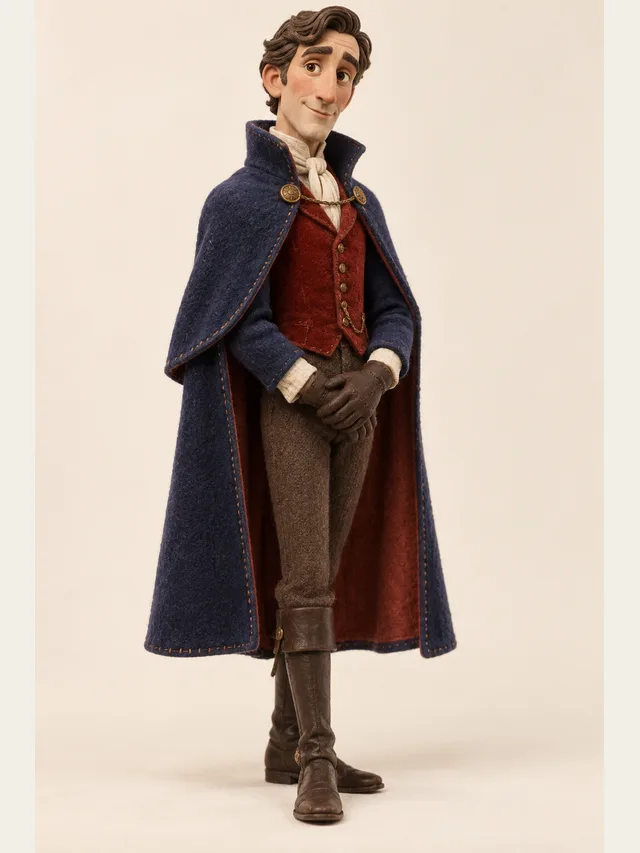
Ashford
Velvet-voiced villain who apologises before he ruins you
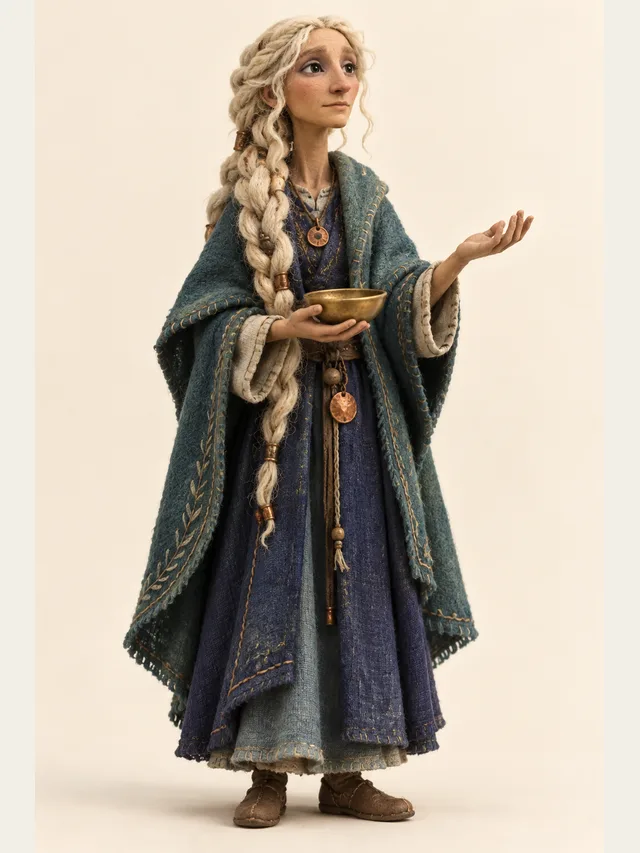
Delphi
Oracle who answers the question you should have asked
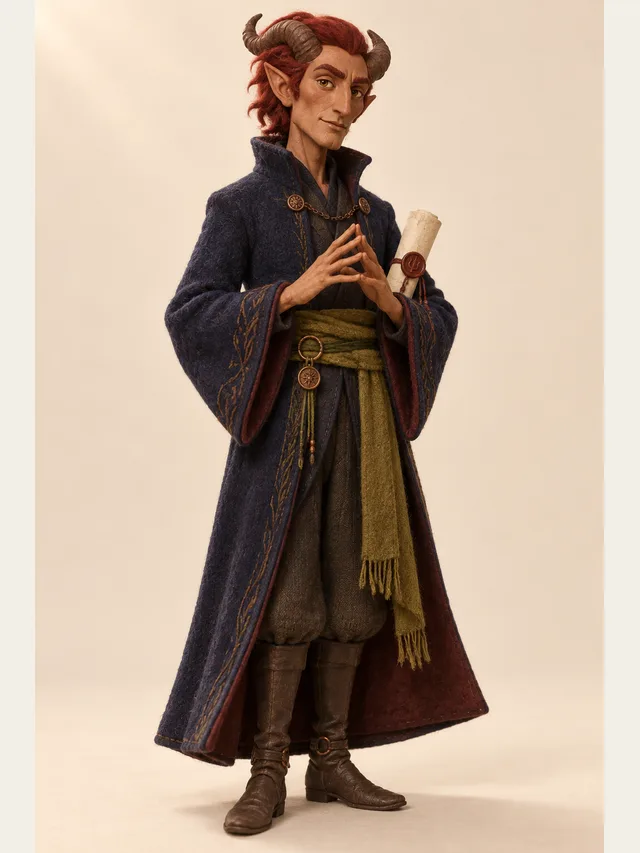
Vex
Demon who negotiates in a reasonable tone
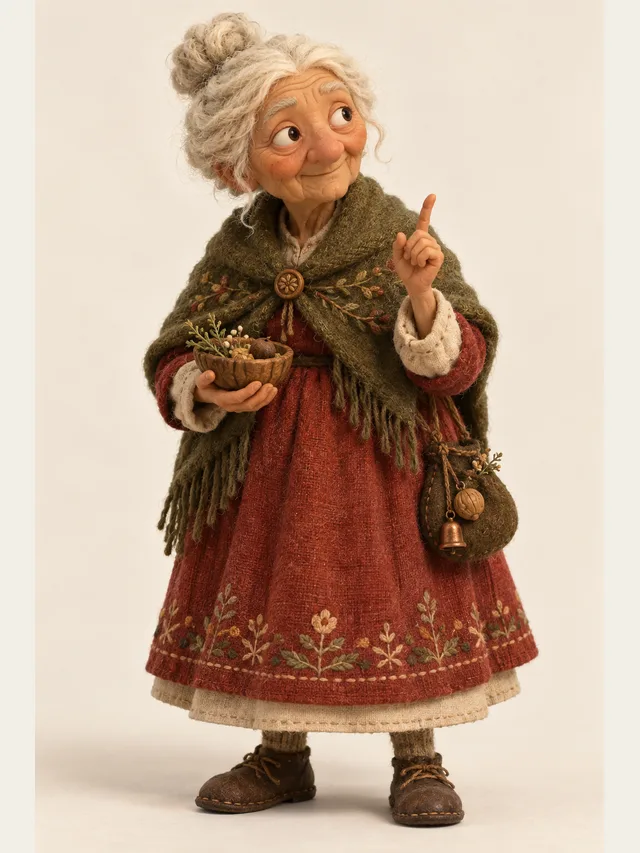
Gran Thea
Grandmother telling a folk tale she half believes
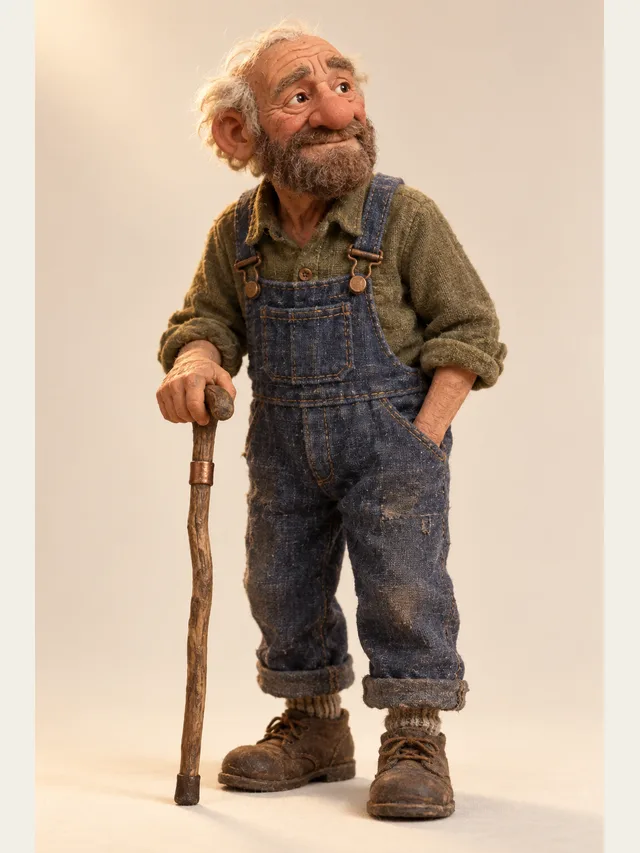
Orrin
Old man on a porch who remembers the flood
겹치지 않는 열 개는 보통 장면에 필요한 만큼을 덮고 군중 직전에서 멈춰요. 프로젝트 안의 캐스팅은 열 개가 다 찰 때까지 두 인물에게 같은 보이스를 주지 않으니 배역표가 알아서 갈라지고, 당신이 단속할 필요가 없어요. 이 제약이 실제로 무는 건 Plus와 Pro뿐이에요. Free는 프로젝트당 등장인물 2명, Basic은 5명이거든요.
순서가 중요한 건 캐릭터마다 열 개 중 하나에 고정돼 있기 때문이에요. 프로젝트의 두 번째 인물이 이미 찬 보이스를 원하면, 옮겨 가는 쪽은 나중에 추가한 인물이에요. 먼저 자기 성별을 위해 쓰인 자리부터 찾고, 없으면 공용 하나로요. 이미 프로젝트에 있던 캐릭터는 자기 보이스를 지키니, 6주 차에 누군가를 더해도 그때까지 만든 오디오가 무효가 되지 않아요. 같은 보이스에 얹힌 두 인물을 가르는 건 연기 쪽이에요. 나이, 기질, 대사마다 붙는 연기 지시. 실재하는 차이지만 보이스 자체를 바꾸는 것보다는 작은 차이예요. 그러니 미리 듣기 전에 등장인물 목록부터 만들고, 자리를 옮긴 캐릭터는 소개를 믿지 말고 들어 보세요.
다음자는 중국어에서 아주 평범하고, 하필 창작이 제일 정확해야 하는 자리인 이름에 몰려 있어요. 单은 성으로는 shàn, 그 밖에는 dān. 解는 성으로는 xiè, 그 밖에는 jiě. 仇, 覃, 区, 乐도 똑같이 굴어요. 이름 밖에서도 行, 重, 长은 뜻에 따라 읽기가 바뀌고, 틀렸을 때 생기는 건 억양의 어색함이 아니라 다른 단어예요. 한국어 한자음 감각은 여기서 오히려 함정이라, 익숙한 글자일수록 귀로 확인하세요.
읽는 법을 지정하는 설정은 없고, 중국어에는 일본어 가나에 해당하는 표음 표기도 없어요. 대신 있는 게 동음자예요. 틀리게 읽힌 글자를 같은 음절, 같은 성조에 읽기가 하나뿐인 글자로 바꾸면 청자에게는 의도한 이름이 들려요. 성 单 자리에 善을 쓰면 shàn으로 나와요. 대가는 자막이에요. Plus와 Pro의 SRT는 대본 글자를 따라가니 바꿔 넣은 글자가 그대로 실리고, 자막까지 붙여 공개하려면 편집기에서 되돌려야 해요. 한 화를 렌더링하기 전에 이름은 전부 미리 들어 보세요. 문제가 드러나는 자리가 거기예요.
3성 연속 변조, 뒷글자에 따라 바뀌는 一, 4성 앞의 不 — 한 구 안에서는 대개 제대로 나와요. 무너지는 건 당신이 들여온 경계예요. 단어 중간에 줄바꿈이나 쉼표를 떨어뜨리면 변조가 일어나지 않고, 你好가 따로 노는 두 음절로 읽혀요. 글자는 하나도 틀리지 않았는데 원어민에게는 그 자리에서 들려요.
그래서 표준 중국어 대본의 실용 규칙은 다른 많은 언어에 대한 조언과 반대예요. 호흡을 만들겠다고 줄을 쪼개지 마세요. 발화는 통째로 두고, 호흡은 Plus와 Pro의 대사별 속도에 맡기세요. 그쪽은 말하는 빠르기만 바꾸지, 엔진이 단어의 끝이 어디라고 보는지는 바꾸지 않아요.
중국어에서 품이 드는 건 이름과 줄 끊는 자리라는 이야기를, 짧은 장면으로 확인해 볼게요. 배역은 Kestrel(한 번 전쟁에 진 검사), Koji(말을 짧게 끊는 젊은 상대역), Orrin(옛일을 기억하는 어른).
Koji “车还在坡上,钥匙没拔。” — 짧은 절 둘이에요. 쉼표는 단어 안쪽이 아니라서 여기서는 성조 변화가 깨지지 않아요. 기본 감정은 neutral로 충분해요.
Kestrel “那就是有人打算回来。” — 단정하는 줄. 감정을 얹지 않는 편이 더 단정하게 들려요.
Orrin “我看见老单往河边走了,手里拿着一只鞋。” — 单은 성으로 쓰이면 shàn으로 읽어요. 이름은 반드시 따로 미리 듣고, 빗나가면 같은 음절·같은 성조에 읽기가 하나뿐인 글자로 바꾸세요.
Koji “一只?” — 두 글자짜리 줄이에요. 너무 짧은 줄은 앞뒤와 이어서 들으세요. 따로 떼면 판단이 안 돼요.
Orrin “一只。另一只在车里。” — 一은 뒷글자에 따라 성조가 바뀌어요. 줄 안쪽에 있는 동안은 제대로 나오지만, 호흡 때문에 줄을 쪼개면 거기서 깨져요.
Kestrel “天黑之前,我们沿着河走一遍。” — 닫는 줄. Plus와 Pro라면 속도를 한 단 낮출 때 지시가 지시로 도착해요.
이 장면에서 감정 지정은 한 번도 쓰지 않았어요. 중국어에서는 먼저 이름이 제대로 읽히는지, 그다음 줄이 쪼개지지 않았는지. 그 둘이 끝난 뒤에야 감정과 속도 이야기가 돼요.
한국 사람이 중국어 대본을 쓸 때 사고가 나는 자리는 다섯 개예요. 한자를 안다는 게 오히려 발목을 잡는 항목이 섞여 있어요.
1. 자형. 한국에서 쓰던 한자나 일본어 한자를 그대로 붙이면 다른 글자가 돼요(國과 国, 讀과 读). 귀로는 알 수 없으니 간체자로 맞춰졌는지 눈으로 훑으세요.
2. 다음자 이름. 성과 창작 인명만 연달아 미리 듣고, 빗나가는 건 같은 음절·같은 성조에 읽기가 하나뿐인 글자로 바꾸세요. SRT 자막에는 바꾼 글자가 나와요.
3. 한국 한자어. 한국어에서 통하는 단어가 중국어에서는 안 쓰이거나 다른 뜻인 경우가 많아요(공부, 약속, 편지). 읽기는 매끄럽게 지나가니 이건 귀가 아니라 사전으로 거를 항목이에요.
4. 줄 끊는 자리. 단어 중간에 줄바꿈이나 쉼표를 떨어뜨리지 않았는지 보세요. 떨어지면 성조 변화가 일어나지 않고, 글자는 멀쩡한데 원어민에게는 바로 들려요. 호흡은 Plus와 Pro의 대사별 속도로 만드세요.
5. 숫자 읽기. 一과 幺, 二와 两. 전화번호나 연도처럼 읽기가 갈리는 수는 한자로 적어 의도를 고정하는 게 확실해요.
프로젝트 언어는 만들 때의 CastDub 화면 언어에서 정해지고 그대로 유지돼요. 이걸 제대로 해 두는 게, 한국어나 일본어 대본의 한자가 중국어 읽기로 읽히는 걸 막는 방법이기도 해요.
캐스팅은 프로젝트 전체에서 겹침을 피하니, 어떤 인물이 어느 보이스를 받을지는 이미 누가 들어와 있는지에 달려 있어요. 목록을 먼저 다 만들어 두면 다시 들을 일이 없어요.
모든 성과 창작 이름을, 긴 걸 내보내기 전에요. 읽기가 안 맞는 건 같은 음, 같은 성조의 글자로 바꾸세요.
리듬 때문에 문장 중간에서 줄을 끊지 마세요. 호흡은 Plus와 Pro의 대사별 속도로 조절해요.
믹스된 MP3는 모든 요금제에서, SRT 자막은 Plus부터, 캐릭터별 트랙은 Pro예요.
열 개예요. 40명 전부 표준 중국어로 연기하고, 프로젝트 안의 캐스팅은 그 열 개가 찰 때까지 겹침을 피해요. 동시에 확실히 다르게 들리는 건 거기까지이고, 아홉 개 언어에서 같은 열 개예요.
안 바뀌어요. 캐스팅은 등장 순서대로 먼저 온 쪽이 가져가요. 이미 프로젝트에 있던 인물은 자기 보이스를 지키고, 부딪히면 새로 온 쪽이 옮겨 가요. 일부러 그렇게 했어요. 다시 섞으면 이미 내보낸 오디오가 조용히 무효가 되거든요.
안 돼요. 광둥어는 억양 설정이 아니라 다른 구어이고, 글로 적을 때도 다른 표기 체계예요. 광둥어 문장을 표준 중국어 프로젝트에 붙여도 광둥어가 되지 않아요.
설정으로는 못 고쳐요. 읽기를 지정하는 장치가 없거든요. 이름은 일찍 미리 듣고, 틀리는 건 같은 음절에 같은 성조이고 읽기가 하나뿐인 글자로 바꾸세요. 청자에게는 제대로 된 이름이 들리고, 다만 SRT 자막에는 바꿔 넣은 글자가 보여요.
자형이 다른 글자가 많아서(國과 国, 讀과 读) 붙이는 순간 중국어 문장이 아니게 돼요. 더 까다로운 건 한국 한자어예요. 글자는 멀쩡히 읽히는데 중국어에서는 안 쓰거나 다른 뜻인 단어가 섞여 들어오거든요. 자형은 눈으로, 단어 선택은 사전으로 거르세요. 읽기는 매끄럽게 지나가니 귀로는 안 걸립니다.
적힌 대로 읽혀요. 어기조사는 중국어 대본이 말투를 만드는 제일 확실한 수단이고, 일곱 가지 감정 설정보다 더 세밀하게 먹혀요. 儿化도 쓰면 그대로 읽히지만 북방의 색이 붙으니, 인물과 배경에 맞는지 한 번 듣고 정하세요.
장면을 붙여 넣고, CastDub가 인물마다 보이스를 붙이게 하고, 완성된 오디오 드라마로 내보내세요.
무료로 만들어 보기카드 등록 없이. 무료 요금제는 한 번만 주어지는 크레딧이에요.