Noor
Newsreader clarity for exposition-heavy scenes
Синтез
Обычный синтез речи озвучивает сплошной текст одним голосом. Для закадрового чтения это правильный инструмент, для сцены — неправильный. Эта страница про сам слой синтеза: что ему можно приказать и где он останавливается.
Noor
Newsreader clarity for exposition-heavy scenes
Quill
YouTube explainer voice that never sounds bored
Dorian
Audiobook baritone for literary fiction and slow reveals
Solène
Continental accent, unhurried, very expensive sounding
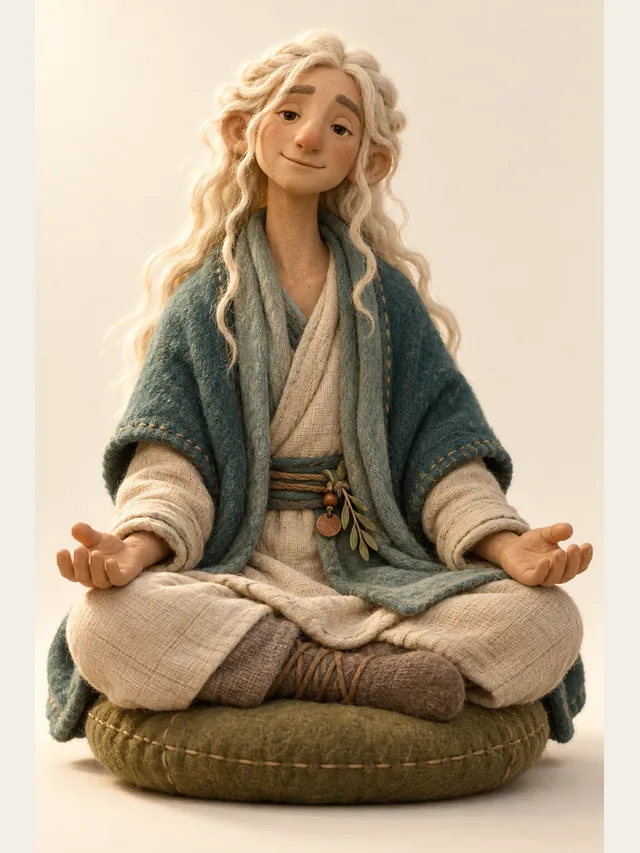
Halcyon
Meditation-adjacent narrator for slow, quiet scenes
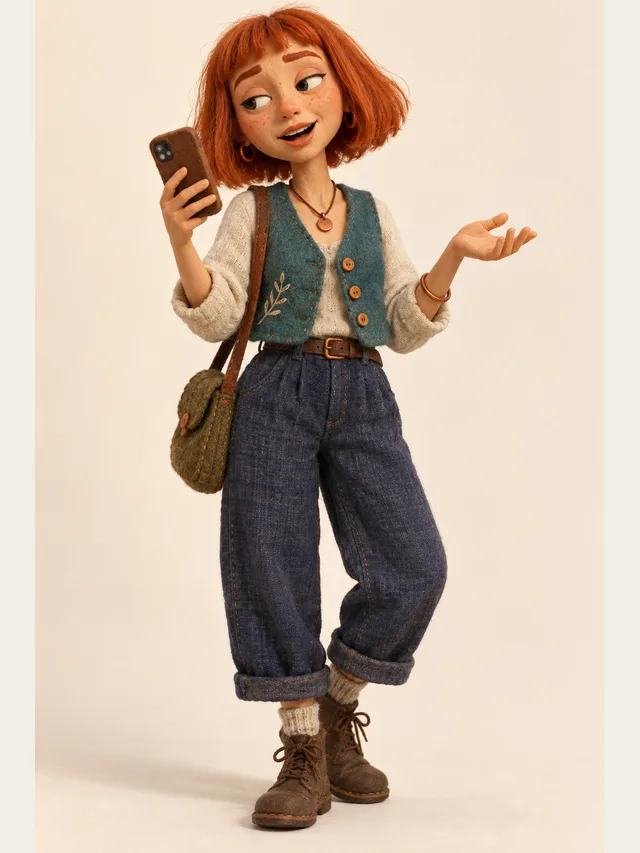
Indie
TikTok voiceover: fast, flat, faintly amused
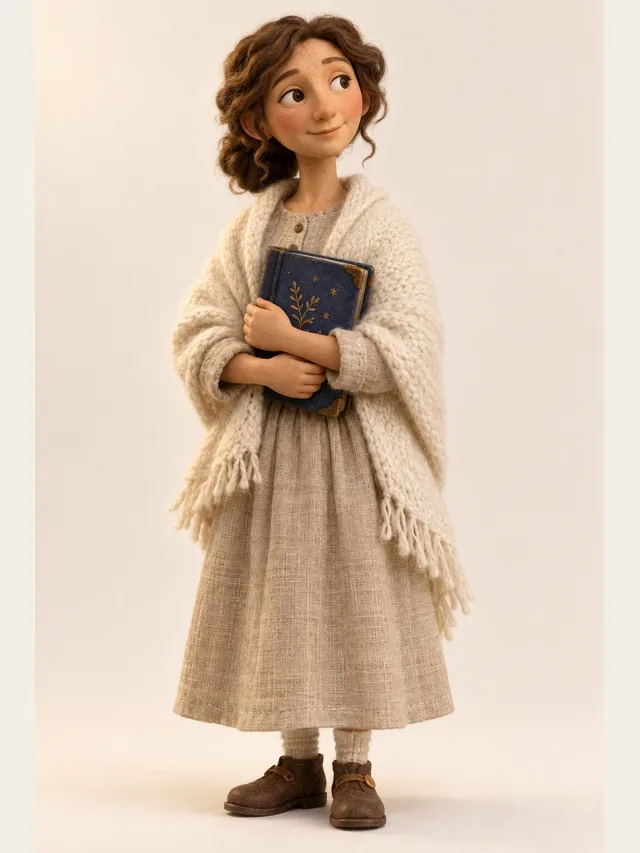
Wren
Bedtime-story narrator, slow and warm, never wakes anyone up
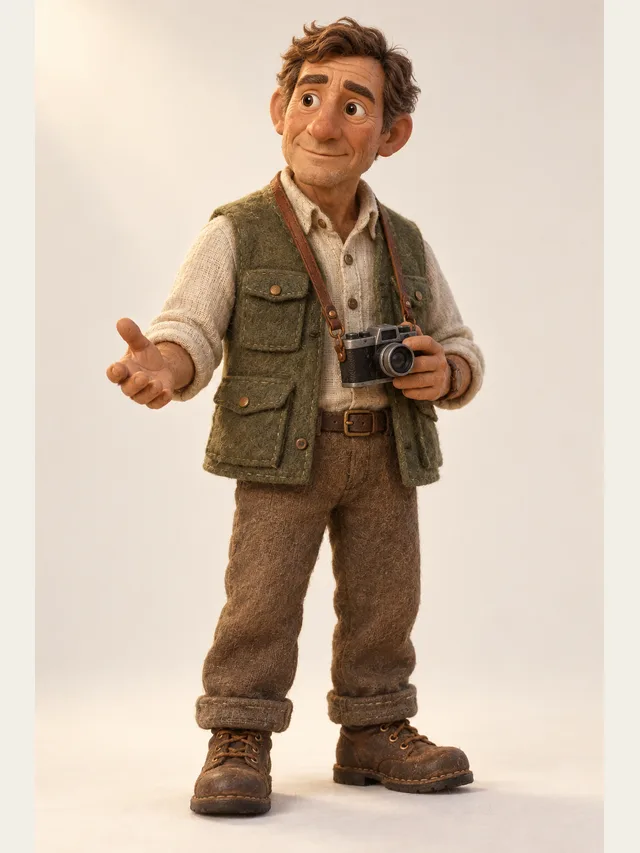
Hale
Documentary narrator with a hand on the listener's shoulder
Нейтрально, радость, грусть, гнев, страх, шёпот и воодушевление — задаются для реплики, а не для документа. С сегодняшним движком любой регистр можно поставить на любой голос, и передаётся он сдвигом темпа, высоты и громкости, а не настоящей моделью эмоций: метки в библиотеке говорят, для каких регистров персонаж задуман, а не какие из них прозвучат.
Множитель скорости для каждой реплики, на Plus и Pro. Темп делает больше, чем принято думать: возраст, авторитет и состояние он передаёт надёжнее, чем высота тона.
Реплика, целиком написанная в скобках, считается указанием исполнителю и вслух не читается. Со сценическими заголовками и описаниями действия иначе: они звучат как текст рассказчика, так что удалите те, которые не должны прозвучать.
Точка — настоящая пауза, многоточие — длиннее, вопросительный знак поднимает конец фразы. Переносы строк создают промежутки. Разметка вашего текста и есть управление таймингом — поэтому на этой странице всё время просят делить реплики.
Движок синтеза стоит за интерфейсом. Сегодня рендерит временный движок, пока подключается боевой; тот же проект отрендерится через другой движок без единой правки в распределении ролей и режиссуре.
Библиотека — не платная стена. Тарифы различаются размером состава, управлением эмоцией и минутами, а не тем, какими голосами вам можно пользоваться.
Один говорящий или много. Для одного голоса это ведёт себя как любой другой синтезатор речи.
Выбирайте из сорока персонажей библиотеки — фильтруйте по возрасту, полу, акценту и стилю, а не прокручивайте список. Прослушивайте на своём тексте, а не на демонстрационном.
Начните с нейтрального и — на Plus или Pro — с темпа чуть медленнее, чем кажется правильным. Почти любая первая попытка слишком быстрая.
Прослушайте каждое имя и выдуманное слово до того, как рендерить что-то длинное, и те, что звучат неверно, перепишите в самом тексте — другим написанием или через дефис: отдельной настройки произношения нет.
Слушайте и в наушниках, и через динамик телефона. Большая часть аудитории — с телефона.
Первый порыв — ставить эмоцию везде, и результат получается однородной кашей. Аудитория считывает эмоцию по контрасту, поэтому сцена с двумя отрежиссированными репликами и двадцатью нейтральными бьёт куда сильнее сцены, где надавлено на всё.
Рабочий порядок такой: задайте персонажу базовый регистр, отрендерите на умолчаниях, прослушайте подряд, а потом отметьте те две-три реплики, где что-то действительно меняется. Для пятиминутной сцены пять реплик вручную — примерно то, что нужно.
Разницу делают четыре привычки. Одно намерение на реплику: фразу, которая уезжает от восторга к ужасу, движок отыграет как среднее из двух, поэтому её надо разделить. Осознанная пунктуация — это ваш тайминг. Междометия отдельными репликами, потому что синтез произносит текст, а не ремарки. И короткие предложения для низких голосов: на длинных периодах они быстро теряют разборчивость.
Ничто из этого не обходной путь вокруг ограничения. Это те же замечания, которые режиссёр даёт живому исполнителю, и по тем же причинам.
Физическая вокализация — крик, рыдание, смех во время речи, кряхтение — самая слабая область, и такой она останется ещё какое-то время, потому что это события дыхания, а не речи. Сгенерируйте их черновиком, если нужно, и планируйте замену.
Второй предел — интерпретация. Синтетическая читка — это чистое, ровное, хорошо отмеренное исполнение написанного. Это не набор решений о подтексте. Для большинства работ такой обмен себя оправдывает; оправдывать его стоит с открытыми глазами на то, какая половина здесь какая.
Для одноголосой работы — почти ничем. Разница появляется в тот момент, когда в сценарии больше одного говорящего: распределение ролей, голос, закреплённый за персонажем в пределах проекта, и режиссура каждой реплики — это и есть продукт, а синтез лежит под ними деталью.
Нейтрально, радость, грусть, гнев, страх, шёпот и воодушевление — на любом голосе. С сегодняшним временным движком это приближения, собранные из темпа, высоты и громкости, а не сыгранные интонации, поэтому прослушайте отрежиссированную реплику, прежде чем на неё полагаться.
Нет: темпом — да, на Plus и Pro; высотой тона — нет. Если утащить голос далеко от его естественного диапазона, появляются артефакты, слышные в хороших наушниках. Лучше выбрать персонажа в нужном диапазоне.
Применяются соглашения локали голоса, поэтому американский голос читает даты по-американски. Ошибки появляются в тексте со смешанными соглашениями: если у вас так, проверьте числа в первую очередь.
Временный — пока подключается боевой. Поэтому голос персонажа из библиотеки лишь приближённо передаёт его характер, а эмоция передаётся темпом и высотой тона. Благодаря интерфейсу поставщика переход не потребует правок в распределении ролей и режиссуре.
Да, но для доступности нужен самый разборчивый голос, а не самый характерный, и проверять надо на скорости 1,5× и выше: многие пользователи экранных дикторов слушают заметно быстрее реального времени.
Вставьте сценарий, дайте CastDub подобрать голос каждому персонажу и экспортируйте готовый аудиоспектакль.
Создать бесплатноКарта не нужна. Free даёт разовый запас кредитов.