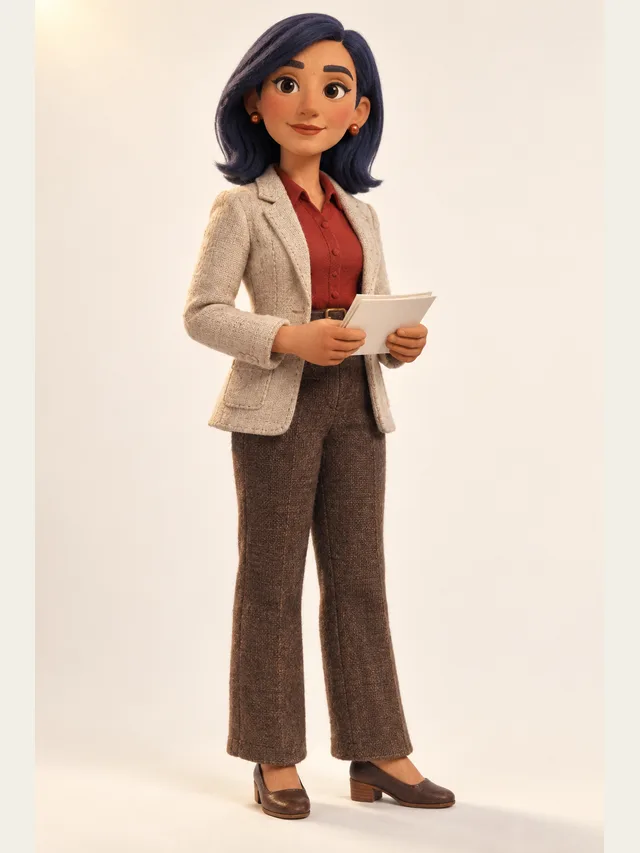
Noor
Newsreader clarity for exposition-heavy scenes
Noor
Newsreader clarity for exposition-heavy scenes
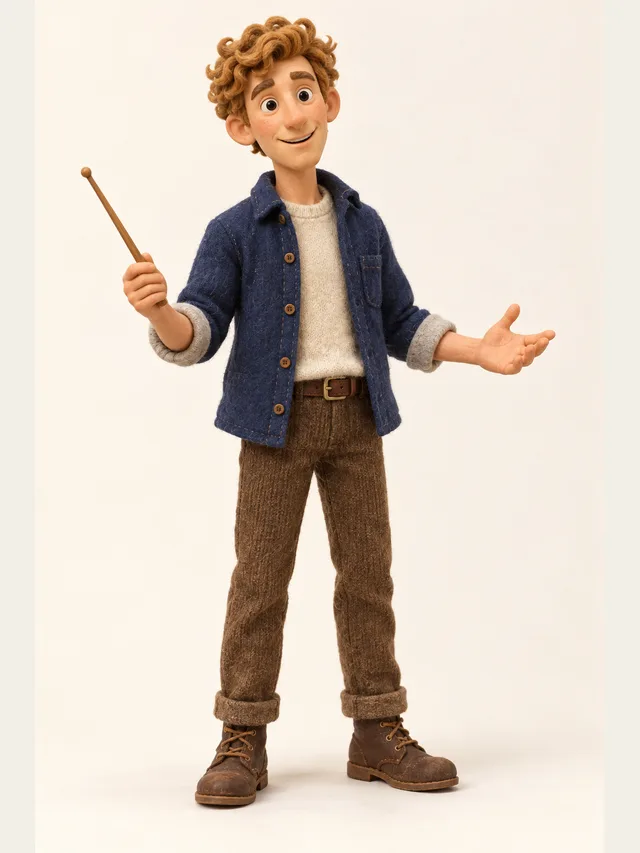
Quill
YouTube explainer voice that never sounds bored
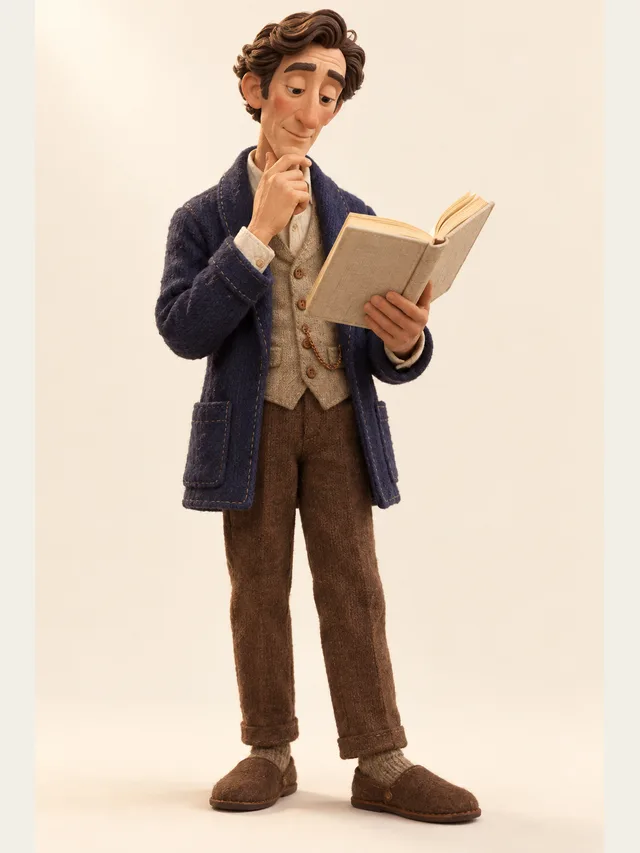
Dorian
Audiobook baritone for literary fiction and slow reveals
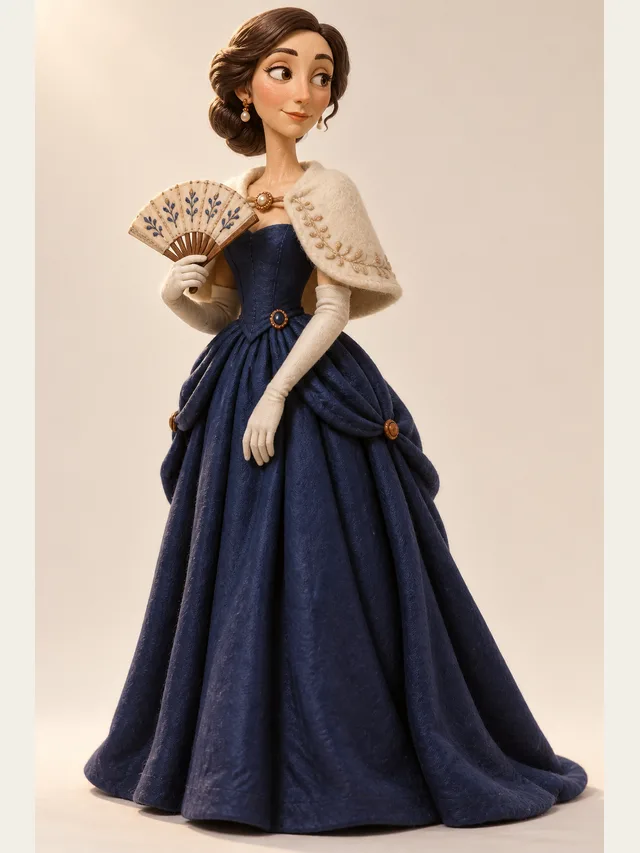
Solène
Continental accent, unhurried, very expensive sounding
Halcyon
Meditation-adjacent narrator for slow, quiet scenes
Indie
TikTok voiceover: fast, flat, faintly amused
Wren
Bedtime-story narrator, slow and warm, never wakes anyone up
Hale
Documentary narrator with a hand on the listener's shoulder
ノーマル、喜び、悲しみ、怒り、恐れ、ささやき、興奮。文書単位ではなく行単位で指定します。どの声にもすべての感情を指定できます。指定した感情はその行の演出指示として渡され、AIの演じ手が実際にそう演じます。話速やピッチをずらして近づけているのではありません。ライブラリのタグが示すのは、そのキャラクターがどの感情を想定して書かれているかで、どれが鳴るかではありません。
PlusとProで使える、行単位の速度倍率です。話す速さは思っているより多くを担っていて、年齢も、立場の強さも、感情の状態も、ピッチより確実に伝えます。
セリフの行頭に置いた括弧、および丸ごと括弧で書かれた行は、その行の演出指示として演じ手に渡され、読み上げません。指示はセリフの横に表示され、その場で直せます。行の途中や末尾の括弧はそのまま残ります——その位置の括弧は読ませたい中身であることが多いからです。柱(シーン見出し)と地の文のト書きは別で、ナレーションとして読まれるので、聞かせたくないものは削除してください。
句点は本当の間になり、三点リーダーはもっと長い間に、疑問符は語尾を持ち上げます。改行は間を作ります。台本のレイアウトが、そのままタイミングの指示になります。このページが何度も「行を分けてください」と言うのは、そのためです。
音声合成エンジンはインターフェースの裏にあります。いまのエンジンが今後入れ替わることはありますが、そのときも同じプロジェクトを、キャスティングと演出を一切変えずに書き出せます。
ライブラリは有料の壁ではありません。プランの差はキャストの人数、感情コントロール、分数であって、どの声を使えるかではありません。
話者が1人でも大勢でも。1つの声だけなら、ほかのテキスト読み上げと同じように動きます。
ライブラリの40人から選びます。延々とスクロールせず、年齢・性別・訛り・スタイルで絞ってください。試し聴きはサンプル文ではなく、自分の原稿で。
ノーマルから始めて、PlusかProなら、ちょうどいいと感じるより少し遅めにしてください。最初の一発目は、たいてい速すぎます。
長いものを書き出す前に、人名と造語をすべて試し聴きし、読みを間違えるものは本文の表記を変えます(かなで書く、区切りを入れるなど)。読みを設定する機能はありません。
ヘッドホンだけでなく、スマートフォンのスピーカーでも鳴らしてください。聴き手の多くはスマートフォンです。
行ごとに感情を指定できると、つい全部に使いたくなります。その結果は、どこも同じにぼやけた芝居です。聴き手は対比で感情を読むので、演出した行が2つで残り20行がノーマルのシーンのほうが、全部を押したシーンよりずっと強く届きます。
うまくいく進め方はこうです。キャラクターごとにふだんの基準を決める。既定のまま書き出す。頭から通して聴く。そのうえで、本当に何かが変わる2〜3行に印をつける。5分のシーンなら、手で演出するのは5行くらいがちょうどいい分量です。
差の大半は4つの癖で決まります。1行にひとつの意図。喜びから恐怖まで振れる一文は両方の平均として読まれるので、分けてください。句読点は意図して打つ。それがタイミングだからです。感嘆や相づちは独立した行にする。括弧のト書きはその行の演じ方を変えるだけで、音そのものにはならないからです。低い声には短い文を。修飾が長く続くと、低音は急に聞き取りにくくなります。
どれも制約に対する裏技ではありません。人の演じ手に演出家が出すのと同じ注文で、理由も同じです。
身体的な発声、つまり叫び、嗚咽、笑いながらのセリフ、力む声がいちばん弱く、当分そのままです。これらは言葉ではなく呼吸の出来事だからです。必要なら仮として生成して、あとで差し替える前提で進めてください。
2つめの限界は解釈です。合成の読みは、書かれたものを、きれいに、ぶれず、テンポよく演じたものです。言外の意味についての判断の積み重ねではありません。たいていの仕事ではこの取引に見合いますが、何を手放しているのかは、目を開けたまま選ぶ価値があります。
1つの声で読むだけなら、大きくは違いません。違いが出るのは、台本に話者が2人以上いた瞬間です。キャスティング、プロジェクトの中でキャラクターごとに固定される声、行ごとの演出がプロダクトで、音声合成はその下の部品です。
ノーマル、喜び、悲しみ、怒り、恐れ、ささやき、興奮で、どの声でも使えます。指定した感情はその行の演出指示として渡され、実際に演じ分けられます。話速やピッチで近づけているのではありません。ただし解釈は毎回まったく同じではないので、演出した行は書き出す前に一度聴いてください。
変えられません。話速はPlusとProで変えられますが、ピッチの調整はありません。地声から遠いピッチ変更は、良いヘッドホンで聴くとはっきり分かる雑味を生むからです。代わりに、その音域のキャラクターを選んでください。
その声のロケールの習慣に従うので、アメリカ英語の声は日付をアメリカ式に読みます。表記の流儀が混ざっているところで間違いが出ます。混在している原稿なら、まず数字から確認してください。
事業者名は出しませんが、動きは説明できます。1行ずつ、AIの演じ手に人物像と演出指示を渡して演じてもらう方式です。基礎の声は10種類(女性4・男性5・中性1)で、そのどれもが対応9言語すべてを話します。ライブラリの40人はそれぞれ決まった基礎の声に乗り、違いは演出指示で作られます。エンジンはインターフェースの裏にあるので、今後入れ替わってもキャスティングや演出はそのまま引き継がれます。
使えます。ただしアクセシビリティ用途では、個性のある声より聞き取りやすい声を選ぶべきですし、1.5倍以上でも試してください。スクリーンリーダーの利用者の多くは、実時間よりかなり速く聴いています。
台本を貼り付ければ、CastDubが登場人物一人ひとりに声を割り当てます。あとは完成したボイスドラマを書き出すだけです。
無料で作ってみるクレジットカードは不要です。無料枠は一度きりの持ち分です。