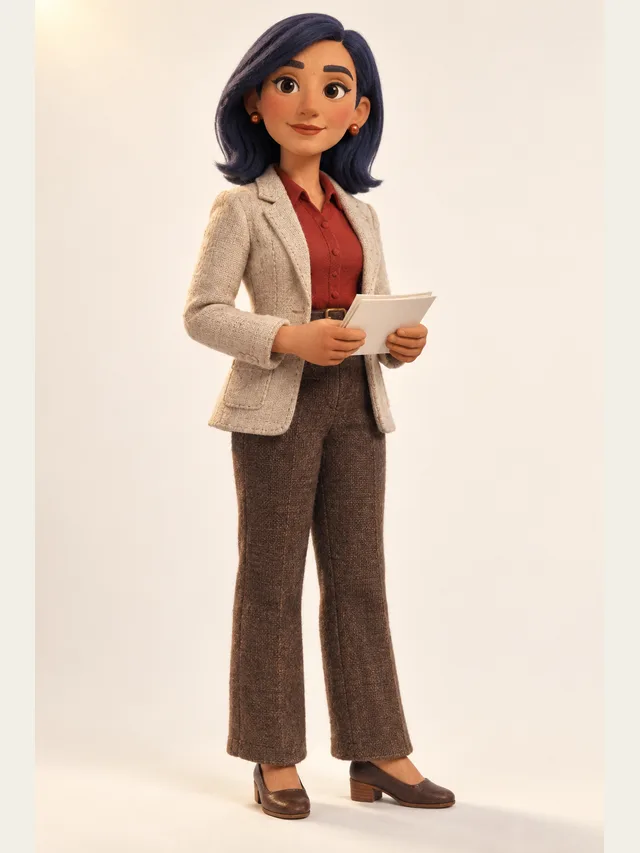
Noor
Newsreader clarity for exposition-heavy scenes
Noor
Newsreader clarity for exposition-heavy scenes
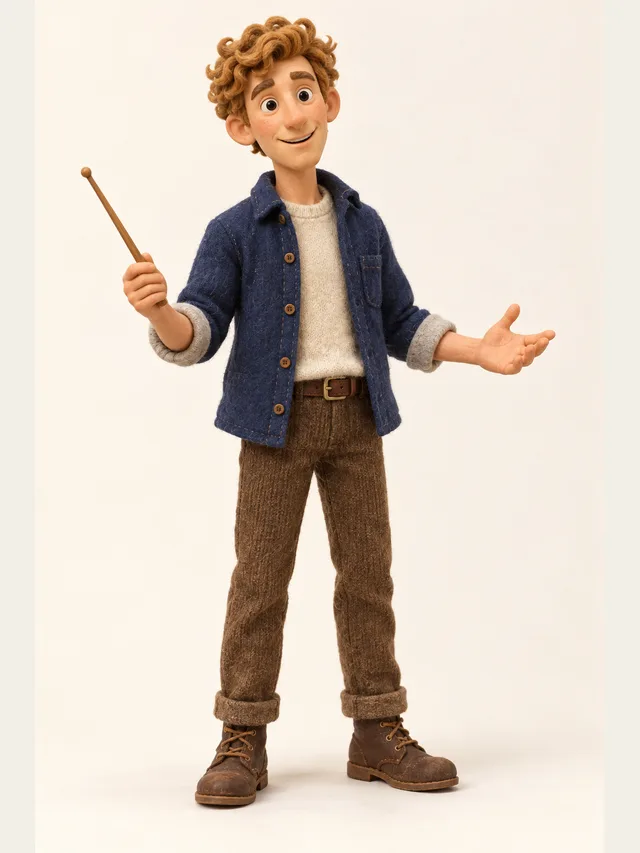
Quill
YouTube explainer voice that never sounds bored
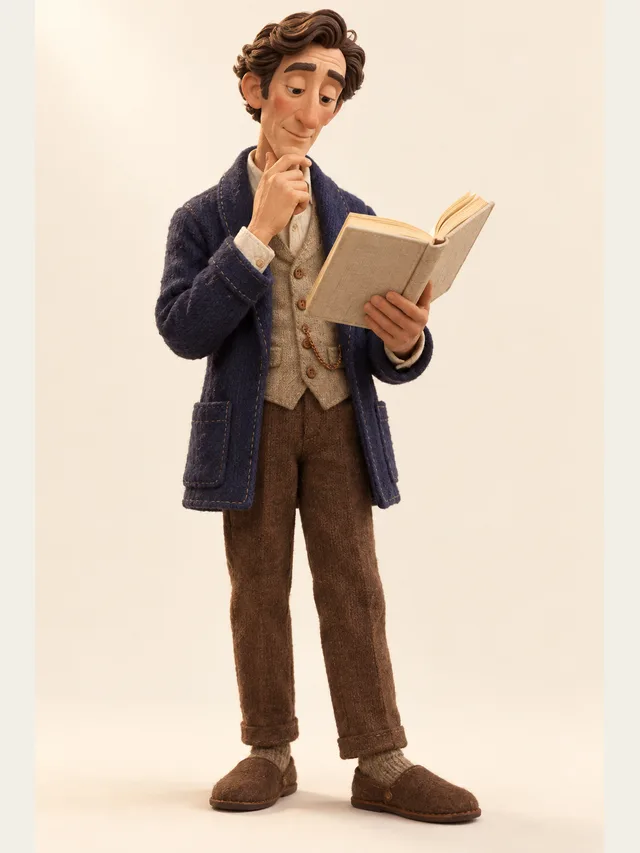
Dorian
Audiobook baritone for literary fiction and slow reveals
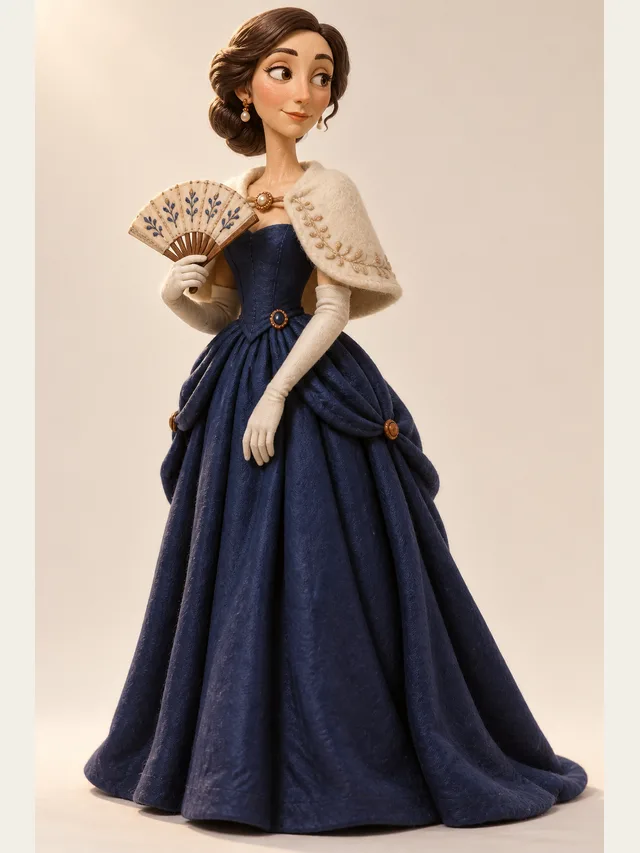
Solène
Continental accent, unhurried, very expensive sounding
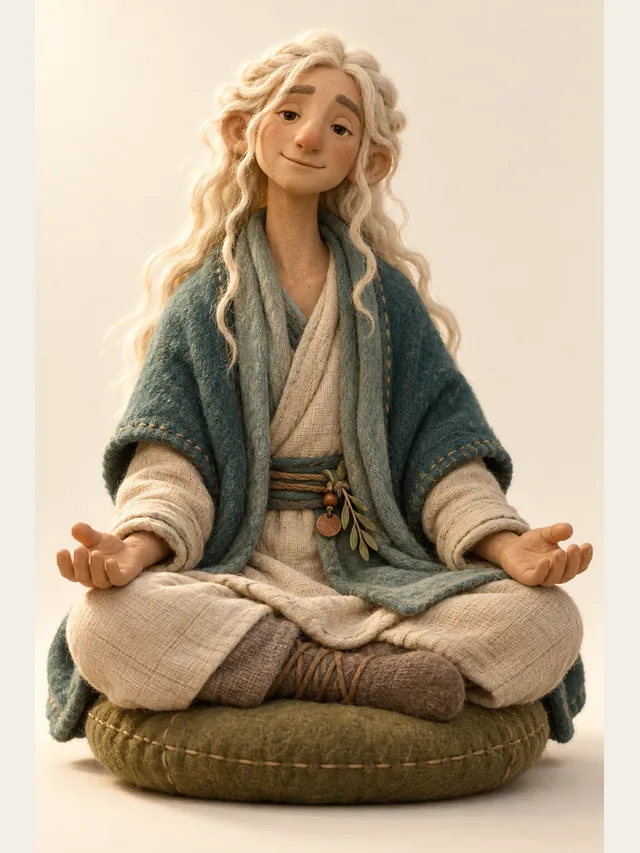
Halcyon
Meditation-adjacent narrator for slow, quiet scenes
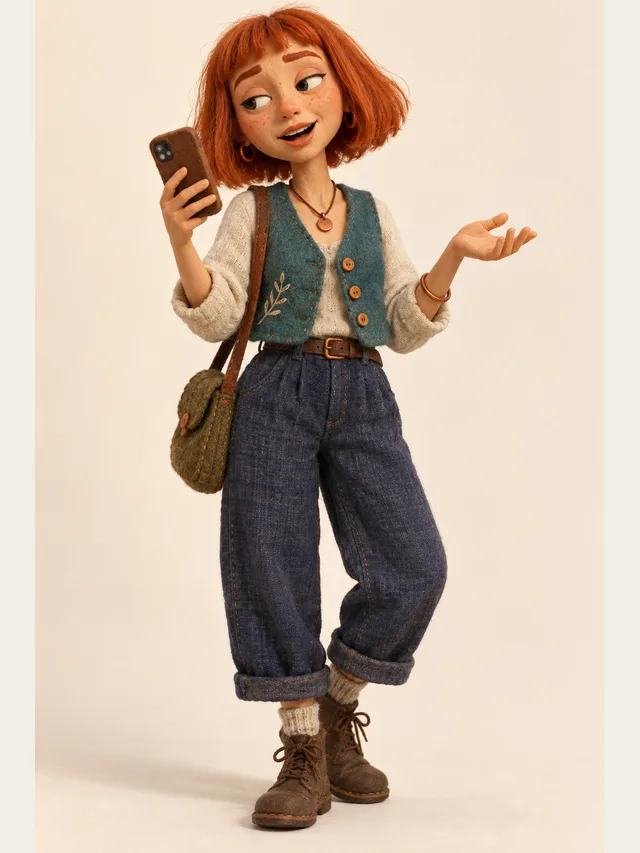
Indie
TikTok voiceover: fast, flat, faintly amused
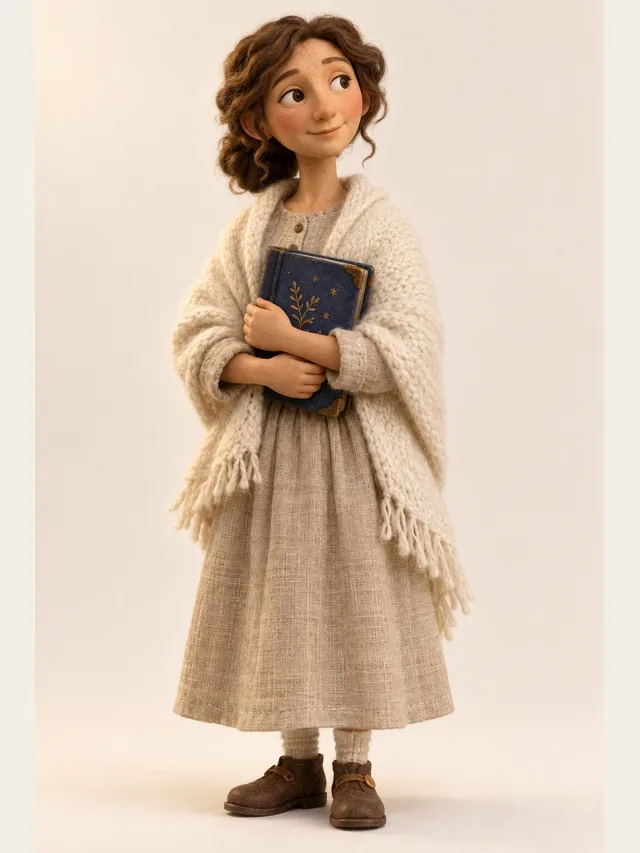
Wren
Bedtime-story narrator, slow and warm, never wakes anyone up
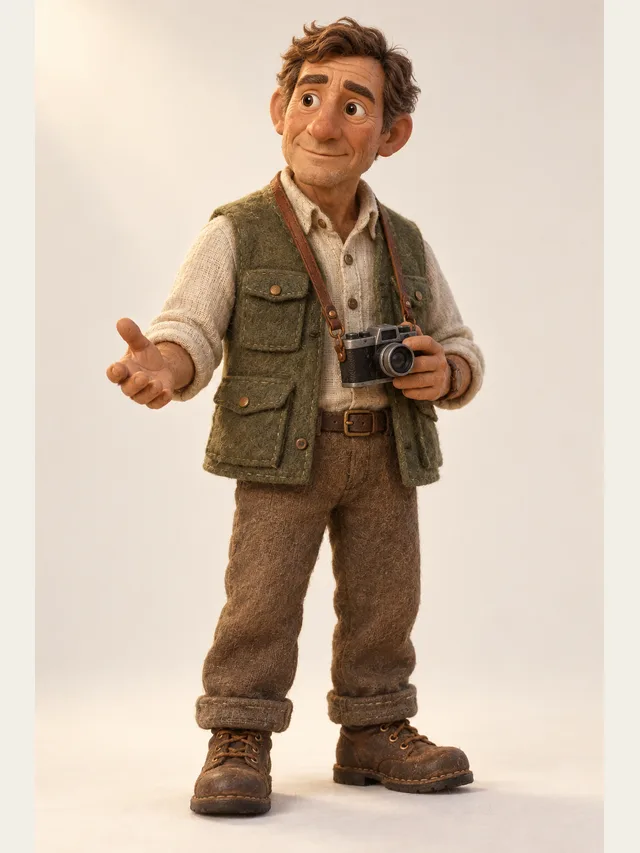
Hale
Documentary narrator with a hand on the listener's shoulder
중립, 기쁨, 슬픔, 분노, 두려움, 속삭임, 들뜸을 문서 단위가 아니라 대사 단위로 지정해요. 지금 엔진에서는 일곱 가지 모두 어느 보이스에나 지정할 수 있고, 진짜 감정 모델이 아니라 속도·음높이·음량을 바꿔서 표현해요. 라이브러리의 감정 태그는 그 캐릭터가 어떤 감정을 염두에 두고 만들어졌는지를 알려 줄 뿐, 어떤 감정이 렌더링되는지를 가르는 게 아니에요.
대사별 속도 배율이고, Plus와 Pro에서 쓸 수 있어요. 속도는 생각보다 많은 일을 해요. 나이와 권위와 감정 상태를 음높이보다 안정적으로 실어 나르거든요.
한 줄 전체가 괄호로 묶여 있으면 연기자에게 주는 메모로 보고 읽지 않아요. 장면 제목과 행동 지문은 얘기가 달라요. 내레이션으로 읽히니까, 들리지 않았으면 하는 줄은 지워 주세요.
마침표는 실제 쉼이고, 말줄임표는 더 긴 쉼, 물음표는 어미를 들어 올려요. 줄바꿈은 간격을 만들고요. 대본을 어떻게 배치했는지가 곧 타이밍 조종간이라, 이 페이지가 자꾸 줄을 나누라고 하는 거예요.
합성 엔진은 인터페이스 뒤에 있어요. 지금은 실제 엔진을 연결하는 동안 임시 엔진이 렌더링을 맡고 있고, 같은 프로젝트를 캐스팅과 연출을 하나도 안 바꾸고 다른 엔진으로 렌더링할 수 있어요.
라이브러리는 유료 장벽이 아니에요. 요금제가 갈리는 지점은 등장인물 수, 감정 지시, 분량이지 어떤 보이스를 써도 되는지가 아니에요.
화자가 한 명이든 여럿이든 괜찮아요. 한 명이면 여느 텍스트 음성 변환 도구와 똑같이 동작해요.
라이브러리의 캐릭터 40개 중에서 고르세요. 스크롤하지 말고 연령·성별·억양·스타일로 추리고, 샘플 문장 말고 본인 텍스트로 들어 보고요.
중립으로 시작하고, Plus나 Pro라면 적당하다 싶은 것보다 조금 느리게 두세요. 첫 시도는 거의 항상 너무 빨라요.
긴 분량을 렌더링하기 전에 이름과 만들어 낸 단어를 모두 들어 보고, 잘못 읽히는 건 텍스트에서 철자를 바꾸거나 띄어 쓰세요. 발음 설정 기능은 없어요.
이어폰뿐 아니라 휴대폰 스피커로도 들어 보세요. 청취자 대부분은 휴대폰으로 들어요.
대사별 감정이 생기면 온 데 다 쓰고 싶어지는데, 그 결과는 전부 고만고만해지는 거예요. 청취자는 감정을 대비로 읽어서, 지시한 대사 두 줄과 중립 스무 줄로 된 장면이 전부 힘이 들어간 장면보다 훨씬 세게 꽂혀요.
결과가 좋은 순서는 이래요. 인물마다 평소 톤을 정하고, 기본값만으로 렌더링하고, 처음부터 끝까지 들어 보고, 그런 다음 실제로 뭔가 바뀌는 두세 줄에만 표시하기. 5분짜리 장면이면 손으로 연출하는 건 다섯 줄쯤이 적당해요.
습관 네 가지가 차이의 대부분을 만들어요. 한 줄에 의도 하나 — 기쁨에서 공포로 넘어가는 문장은 둘의 평균으로 읽히니까 줄을 나누세요. 문장부호는 타이밍이니 일부러 찍으세요. 감탄사는 따로 한 줄로 — 렌더러는 지문이 아니라 텍스트를 읽으니까요. 그리고 낮은 목소리에는 짧은 문장을 — 저음은 절이 길어지면 알아듣기가 급격히 나빠져요.
이건 한계를 피해 가는 요령이 아니에요. 연출자가 사람 연기자에게 주는 것과 같은 노트이고, 이유도 같아요.
몸으로 내는 소리 — 비명, 흐느낌, 말하면서 웃기, 힘쓰는 소리 — 가 가장 약하고 한동안 그럴 거예요. 말이 아니라 호흡이거든요. 필요하면 임시로 생성해 두되, 나중에 바꿀 계획으로 두세요.
두 번째 한계는 해석이에요. 합성된 낭독은 쓰인 그대로를 깔끔하고 일정하고 속도감 있게 읽어 주는 연기예요. 서브텍스트에 대한 판단의 묶음은 아니고요. 대부분의 작업에서 이 거래는 할 만하지만, 어느 쪽이 어느 쪽인지는 알고 하시는 게 좋아요.
목소리가 하나인 작업이면 크게 다르지 않아요. 차이는 대본에 말하는 사람이 둘 이상 생기는 순간 나타나요. 캐스팅, 프로젝트 안에서 인물마다 고정되는 목소리, 대사별 연출이 제품이고 합성은 그 밑의 부품이에요.
중립, 기쁨, 슬픔, 분노, 두려움, 속삭임, 들뜸이고, 모든 보이스에서 돼요. 다만 지금의 임시 엔진에서는 연기라기보다 속도·음높이·음량으로 흉내 낸 근사치라서, 연출한 대사는 믿고 쓰기 전에 한 번 들어 보세요.
아니요. 말속도는 Plus와 Pro에서 되지만 음높이는 안 돼요. 원래 음역에서 멀리 떨어뜨리면 좋은 이어폰에서 티가 나는 인위적인 소리가 생기기도 하고요. 그 음역에 맞는 캐릭터를 고르세요.
보이스의 로캘 관례를 따라서 미국 보이스는 날짜를 미국식으로 읽어요. 관례가 섞인 텍스트에서 실수가 나오니, 표기가 섞여 있다면 숫자부터 확인하세요.
실제 엔진을 연결하는 동안 쓰는 임시 엔진이에요. 라이브러리 캐릭터의 목소리가 설정에 가까운 근사치이고 감정이 속도와 음높이로 표현되는 것도 그래서예요. 엔진 인터페이스가 있어서, 엔진이 바뀌어도 캐스팅과 연출은 손대지 않아도 돼요.
네. 다만 접근성이라면 개성 있는 보이스보다 가장 또렷한 보이스가 좋고, 1.5배속 이상에서도 확인해 보세요. 스크린 리더 사용자 상당수는 실제 속도보다 훨씬 빠르게 들어요.
장면을 붙여 넣고, CastDub가 인물마다 보이스를 붙이게 하고, 완성된 오디오 드라마로 내보내세요.
무료로 만들어 보기카드 등록 없이. 무료 요금제는 한 번만 주어지는 크레딧이에요.