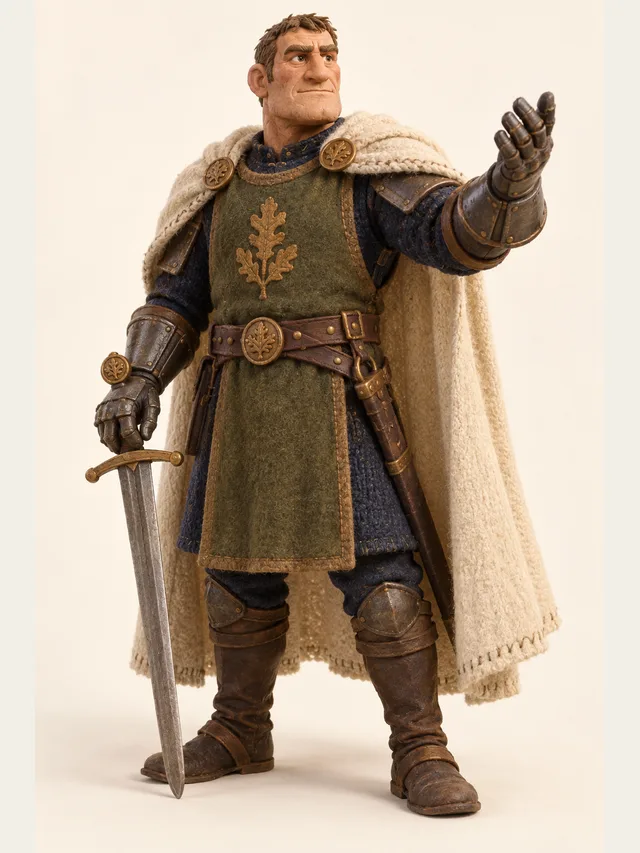
Torvald
Knight commander who gives orders that men actually follow
Produto
Isto aqui é o produto. Todo o resto do site é uma porta de entrada para ele. Você traz um roteiro com mais de uma pessoa dentro; a CastDub descobre quem são, dá um intérprete a cada uma e coloca na sua mão os controles que um diretor usaria.
Torvald
Knight commander who gives orders that men actually follow
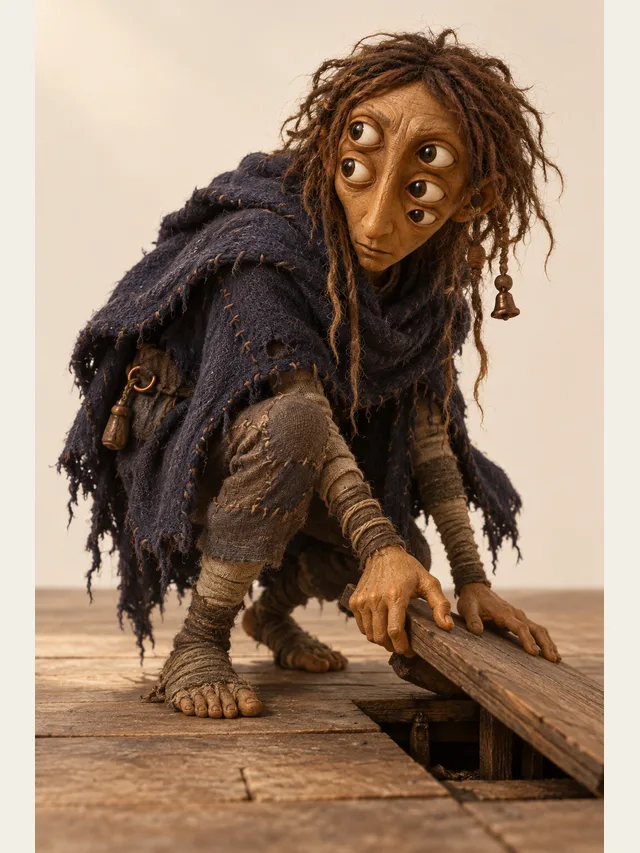
Morrow
Something under the floorboards that learned your name
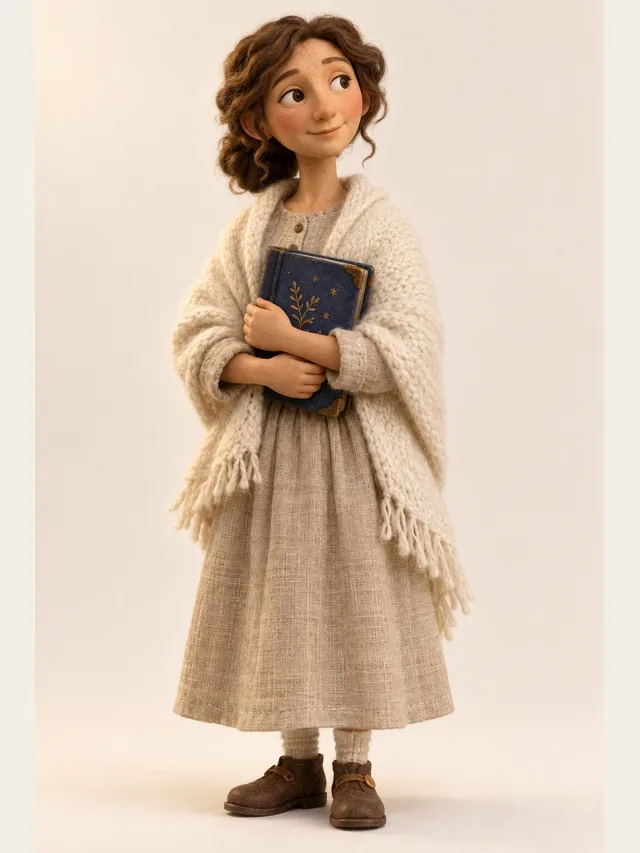
Wren
Bedtime-story narrator, slow and warm, never wakes anyone up
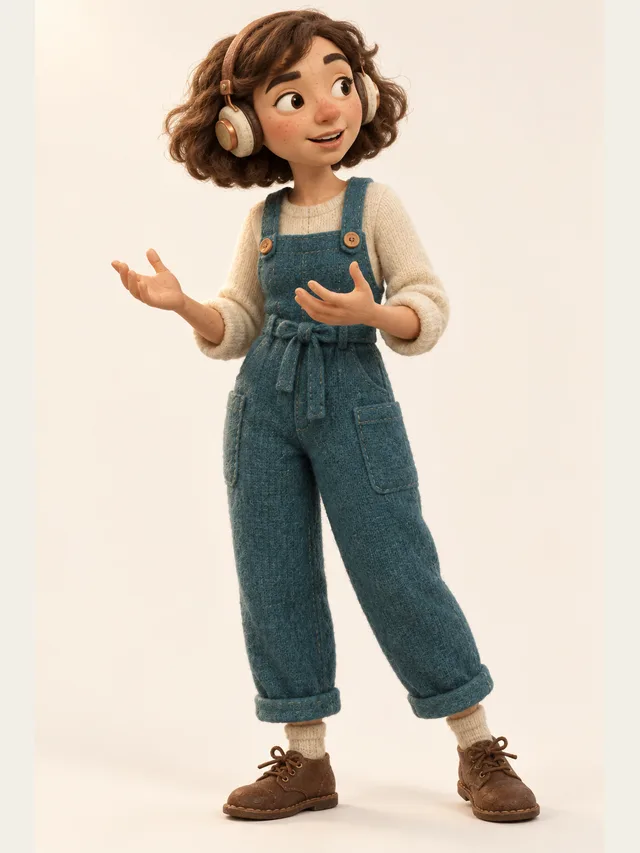
Juno
Podcast host who thinks out loud and never reads a script
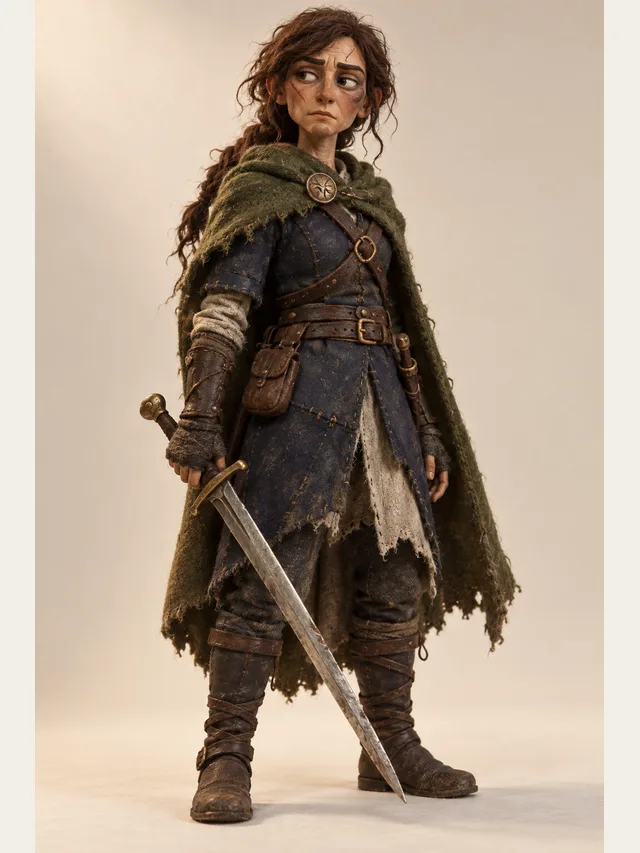
Kestrel
Low, weary swordswoman who has already lost this war once
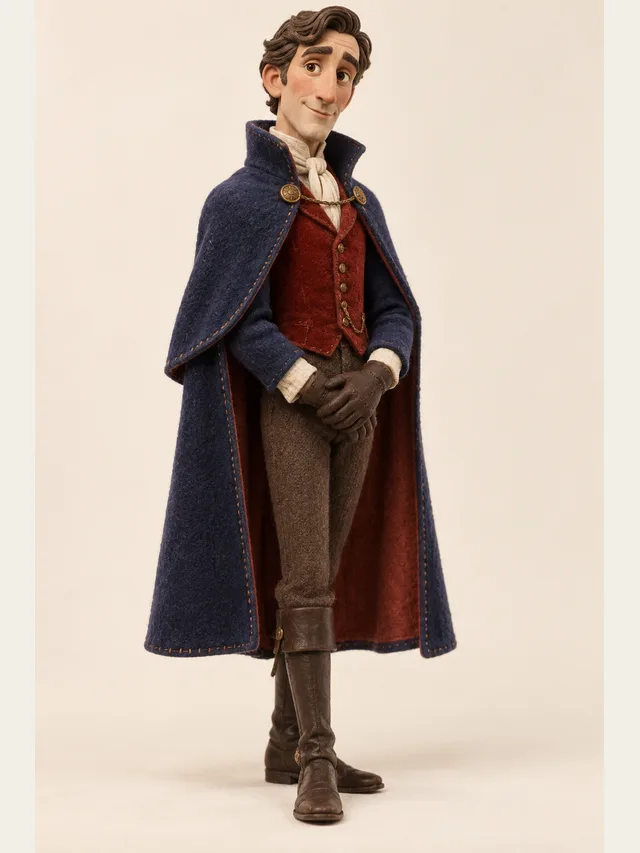
Ashford
Velvet-voiced villain who apologises before he ruins you
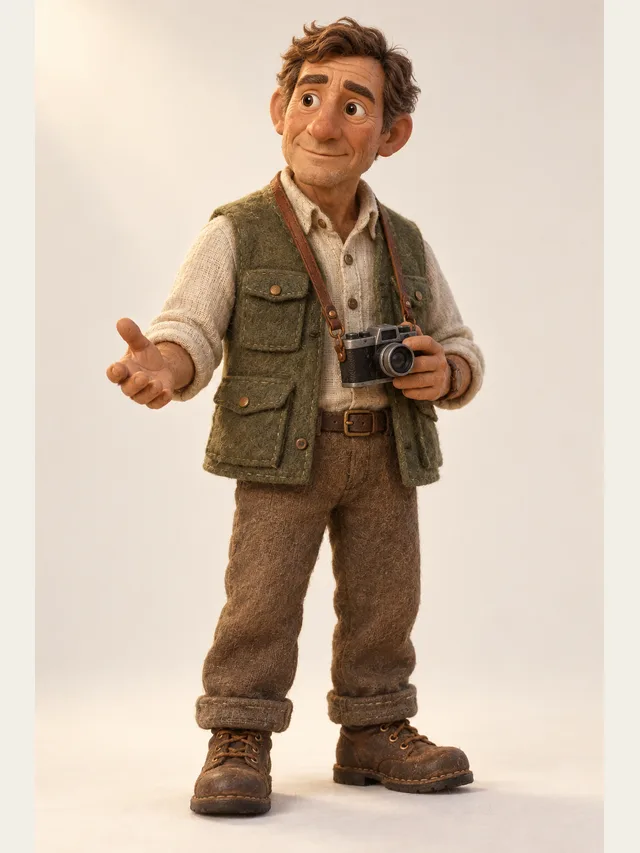
Hale
Documentary narrator with a hand on the listener's shoulder
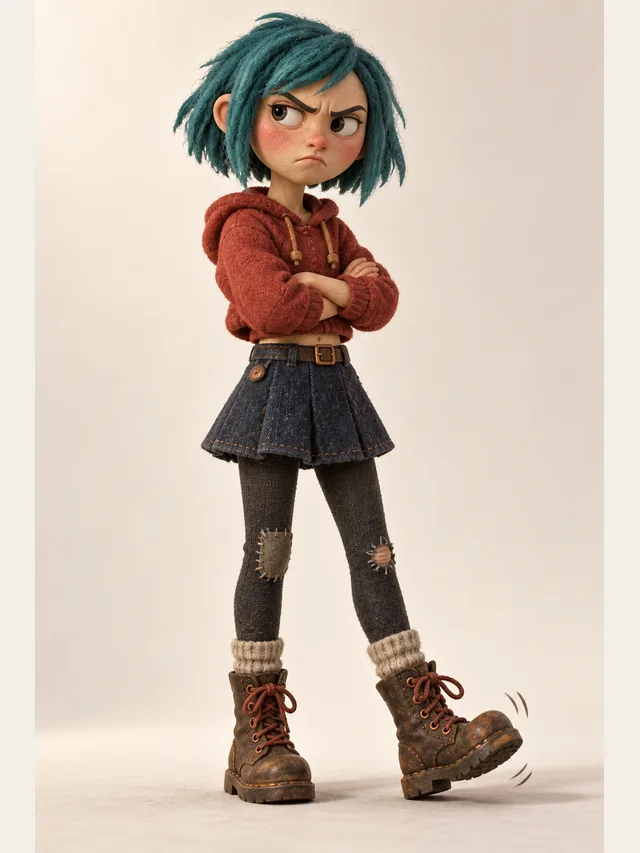
Cass
Seventeen and furious about it, in a good way
Formato de roteiro, falas começando com “Nome:” e prosa comum com verbos de fala são todos lidos como foram escritos. Cole de um documento, de um programa de roteirização ou de uma coluna de planilha. Não há envio de arquivo — .txt, .docx e .srt não são importados, então copie o texto para dentro.
A detecção de interlocutor separa o roteiro por quem está falando e então propõe um personagem da biblioteca para cada interlocutor, a partir de como o roteiro o apresenta. É uma proposta, não uma decisão — toda escalação pode ser trocada, e a troca vale para o resto do projeto.
A emoção é uma propriedade da fala, não do personagem. Defina um registro de repouso por personagem e marque só as falas em que ele se quebra. É o único mecanismo que separa uma leitura de uma interpretação, e é o principal que o Pro acrescenta: nos outros planos, cada fala segue o registro de repouso do personagem.
Nome, perfil, gênero, faixa etária, personagem da biblioteca e emoção padrão, definidos uma vez dentro do projeto. Dois personagens do mesmo projeto não dividem voz até o idioma ficar sem vozes, e acrescentar um depois não embaralha os outros. Personagens não passam de um projeto para outro, então uma série escolhe de novo os mesmos personagens da biblioteca em cada episódio.
Edite uma fala e só ela é sintetizada de novo; todo o resto mantém o áudio que já tinha. Num projeto longo, é a diferença entre revisar à vontade e temer cada reescrita — três falas alteradas custam três falas de geração, não uma renderização inteira.
Um MP3 mixado em qualquer plano, as faixas separadas por personagem em um ZIP no Pro, para trilha e desenho de som, e, a partir do Plus, um SRT gerado a partir do seu roteiro em vez de transcrito — então os nomes saem escritos certo e os tempos já batem.
Copie como texto. Sem etapa de reformatação, sem modelo para preencher.
Revise a voz proposta para cada personagem, ouça as alternativas na mesma fala e trave a que servir.
Dê a cada personagem uma emoção padrão. A maior parte da cena roda no padrão.
Marque as falas específicas em que o registro se quebra — normalmente de três a cinco por cena.
Problemas de ritmo são invisíveis fala a fala e escancarados quando você ouve tudo seguido.
Mixagem, faixas separadas ou legendas, conforme o destino do áudio.
Síntese de voz virou commodity. Vários fornecedores produzem áudio bom o bastante para dramaturgia, e a diferença entre eles é menor do que a diferença entre uma cena bem escalada e uma mal escalada. O que não é commodity é tudo o que cerca a síntese: descobrir quem está falando, manter um personagem estável por meses, dirigir falas individuais e tirar o áudio num formato que dê para mixar.
É por isso que a camada de fornecedor aqui é uma interface com várias implementações atrás dela. Se aparecer um motor melhor no ano que vem, trocar vira mudança de configuração e não reconstrução, e os seus projetos, a escalação e a direção fala a fala atravessam intactos.
Ela não escreve roteiros. Diálogo gerado interpretado por vozes geradas é um produto que ninguém pediu duas vezes, e o problema interessante do audiodrama é a produção, não a ideia.
Ela não mixa. Sem cama de música, sem reverb, sem posicionamento estéreo. Isso é trabalho de editor de áudio, onde você ouve tudo junto, e embutir essas coisas numa ferramenta de renderização produziu, com uma regularidade impressionante, algo pior do que as duas separadas.
Ela não sobrepõe diálogo numa renderização só. Falar por cima de alguém é um recurso dramático de verdade e é uma operação de mixagem — exporte as faixas separadas e deslize uma sobre a outra. É um arrasto em qualquer editor, e é a coisa mais realista que você pode fazer com uma discussão.
A vocalização física é o limite atual: gritar, chorar, rir enquanto fala, grunhidos de esforço. São eventos de respiração, não eventos de fala, e é aí que um ouvinte identifica que o áudio é gerado. Escreva em volta deles quando der, e grave as duas ou três falas que os carregam quando não der. Misturar áudio gravado e gerado na mesma produção é normal — isso acontece no seu editor de áudio, já que gravações não podem ser colocadas dentro de um projeto —, e a emenda não aparece quando a escrita segura o momento.
Monólogos emocionais muito longos são o segundo ponto fraco, por um motivo parecido: um intérprete humano toma uma decisão sobre o subtexto a cada poucos segundos ao longo de um monólogo, e nada aqui tenta fazer isso.
Nenhum — não há envio de arquivo. Cole o próprio texto, em formato de roteiro, falas no estilo “Nome:” ou prosa com verbos de fala. De um documento do Word ou de um arquivo de legenda, copie o texto e cole aqui.
Em formatos de roteiro, quase sempre. Em prosa, depende de quão explícita é a atribuição — trechos longos de diálogo sem atribuição e personagens chamados por epíteto são os casos de falha previsíveis. Passar os olhos na escalação antes de renderizar leva um minuto.
Dá, e é esse recurso que torna projetos longos viáveis. Mude a fala, renderize só ela, e todo o resto mantém o áudio que já tinha.
Não. Um personagem só existe dentro do projeto dele. Para uma série, crie um projeto novo por episódio, escolha os mesmos personagens da biblioteca e escreva os mesmos perfis. Não há garantia da mesma voz entre projetos, porque as vozes são mantidas distintas na ordem em que os personagens são acrescentados em cada projeto — então ouça a primeira fala do protagonista antes de exportar.
Aqui não. Exporte as faixas separadas e faça a trilha num editor de áudio. É uma fronteira deliberada, não um recurso faltando.
Só o Pro. No Free, no Basic e no Plus, cada fala segue a emoção padrão do personagem, o que basta para conferir se a cena funciona, mas não para colocar uma virada específica numa fala específica.
Cole um roteiro, deixe a CastDub dar uma voz a cada personagem e exporte um audiodrama pronto.
Criar de graçaSem cartão de crédito. O Free dá um bolo único de créditos.