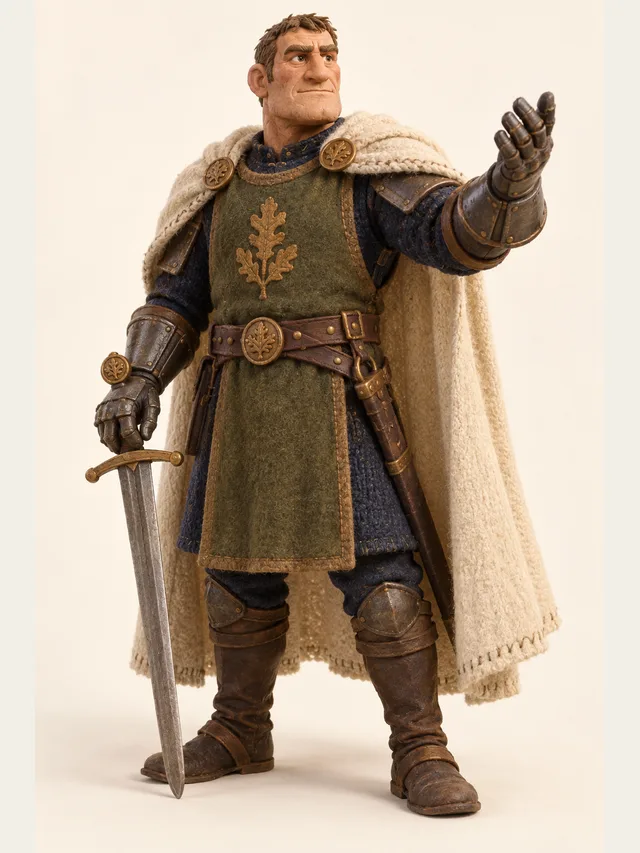
Torvald
Knight commander who gives orders that men actually follow
Producto
Este es el producto. Todo lo demás en el sitio es una puerta de entrada a esto. Tú traes un guion con más de una persona dentro; CastDub averigua quiénes son, le da un intérprete a cada una y te entrega los controles que usaría alguien que dirige.
Torvald
Knight commander who gives orders that men actually follow
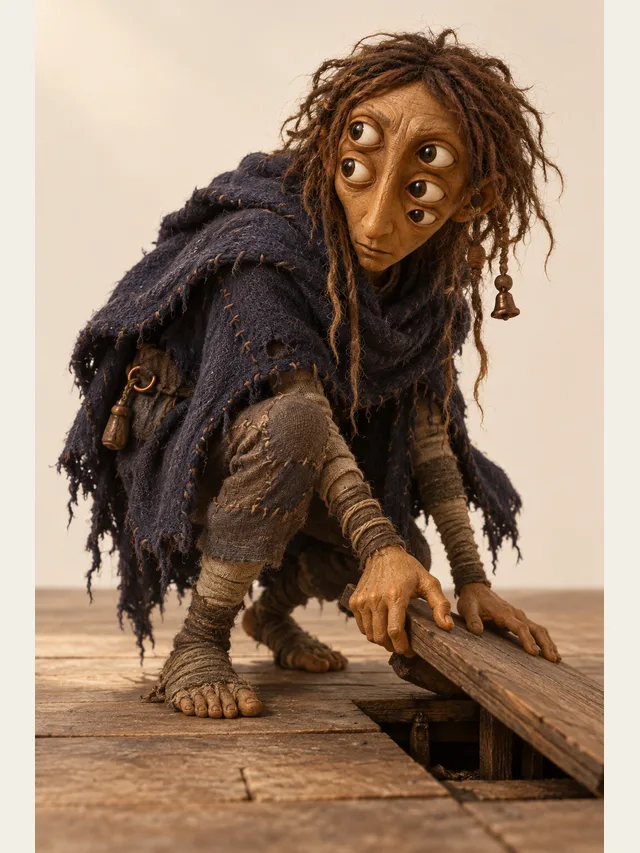
Morrow
Something under the floorboards that learned your name
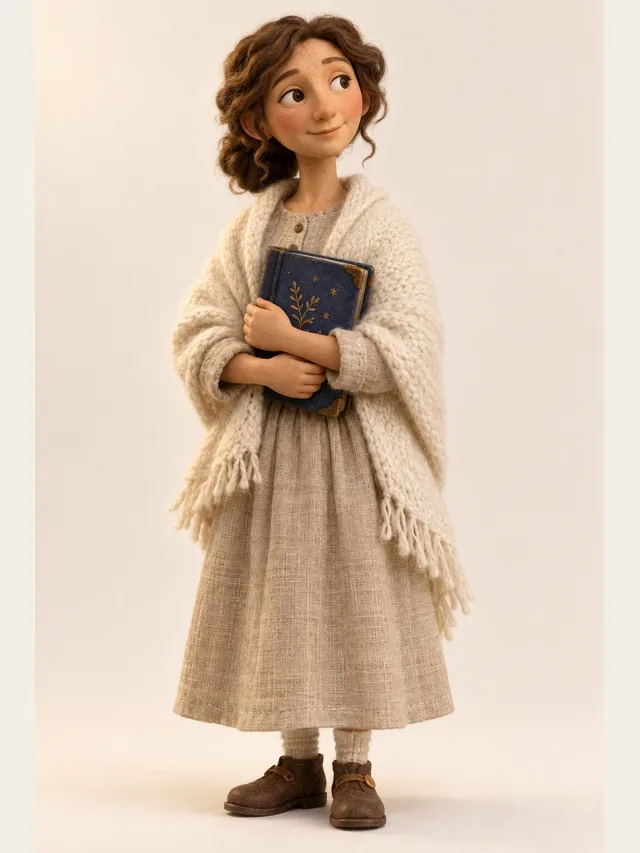
Wren
Bedtime-story narrator, slow and warm, never wakes anyone up
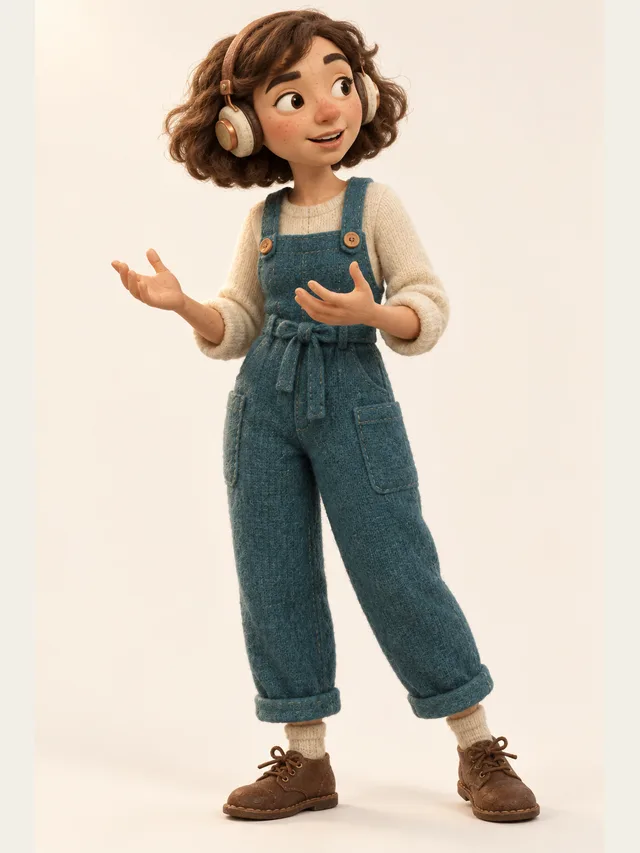
Juno
Podcast host who thinks out loud and never reads a script
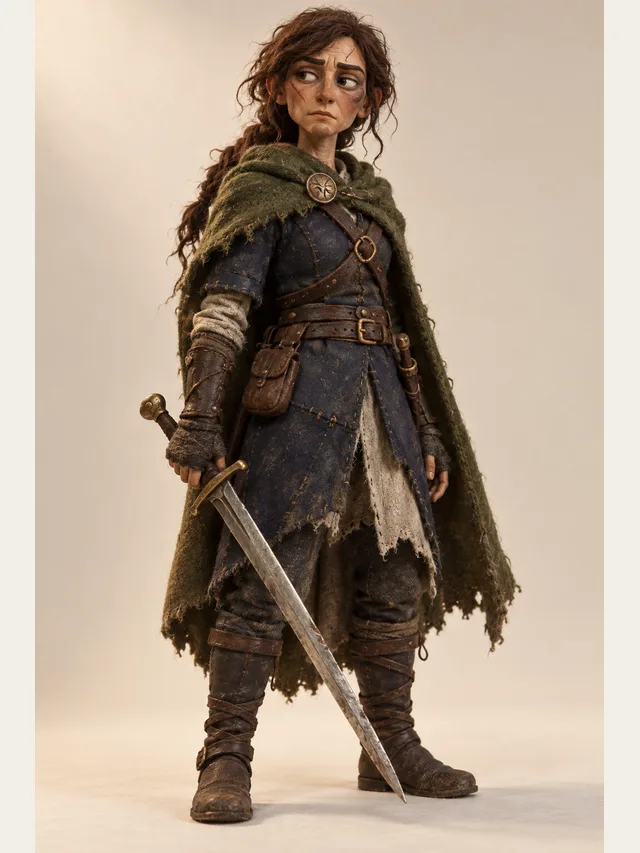
Kestrel
Low, weary swordswoman who has already lost this war once
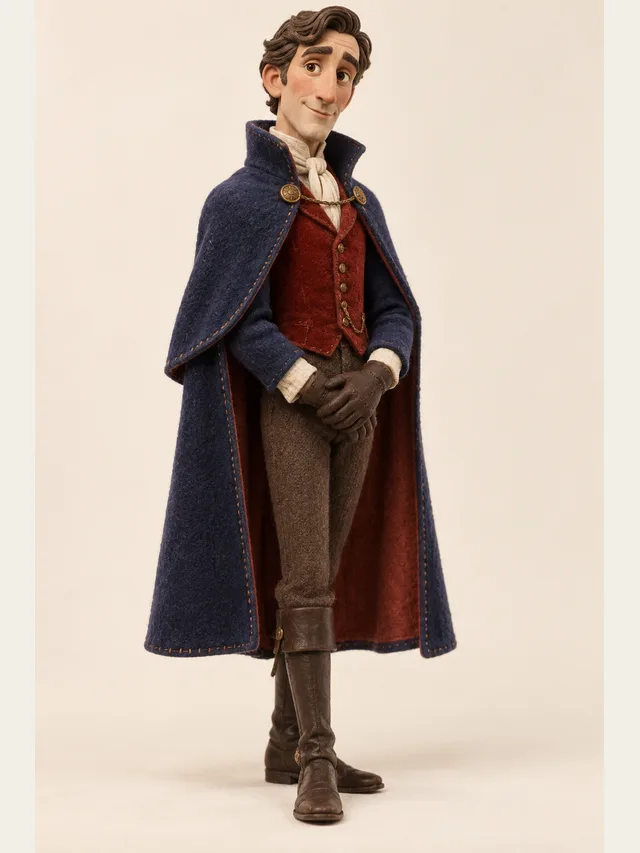
Ashford
Velvet-voiced villain who apologises before he ruins you
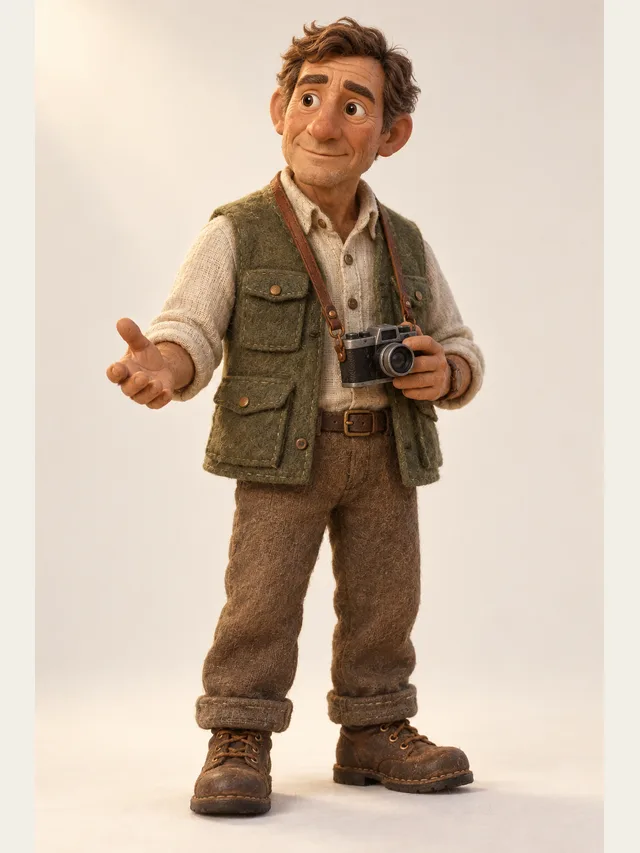
Hale
Documentary narrator with a hand on the listener's shoulder
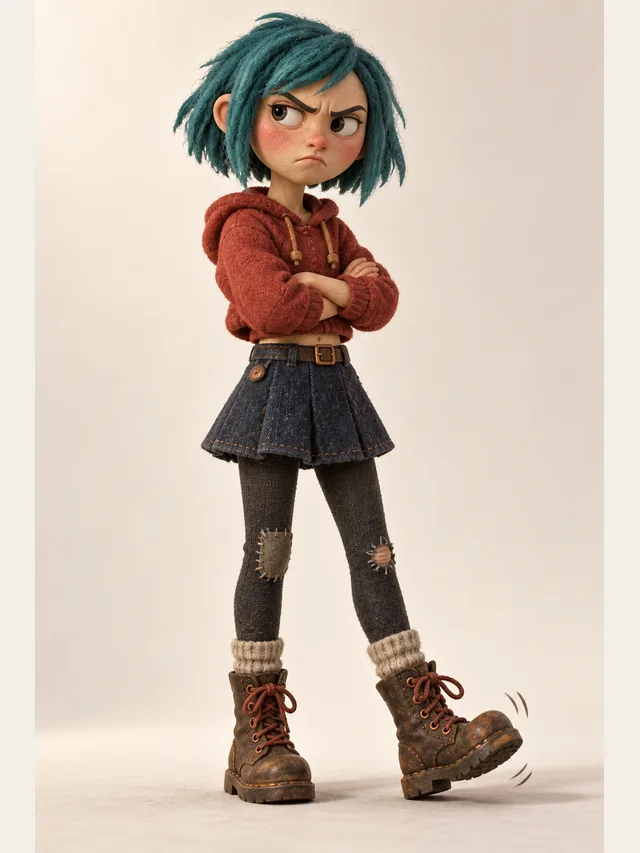
Cass
Seventeen and furious about it, in a good way
El formato de guion cinematográfico, las líneas que empiezan con «Nombre:» y la prosa corriente con diálogo marcado con raya se leen tal como están escritos. Pega desde un documento, desde un programa de escritura de guiones o desde una columna de una hoja de cálculo. No hay subida de archivos: los .txt, .docx y .srt no se importan, así que copia el texto y pégalo.
La detección de hablantes separa el guion según quién habla y después propone un personaje de la biblioteca para cada hablante a partir de cómo lo presenta el guion. Es una propuesta, no una decisión: cualquier asignación se puede cambiar, y el cambio queda fijo durante el resto del proyecto.
La emoción es una propiedad de la línea, no del personaje. Fija un registro de base por personaje y marca solo las líneas donde ese registro se quiebra. Este es el único mecanismo que separa una lectura de una interpretación, y es lo principal que añade Pro: en los demás planes cada línea sigue el registro de base de su personaje.
Nombre, perfil, género, franja de edad, personaje de la biblioteca y emoción por defecto, definidos una vez dentro del proyecto. Dos personajes de un proyecto no comparten voz hasta que el idioma se queda sin voces distintas, y agregar uno más tarde no reordena a los demás. Los personajes no pasan de un proyecto a otro, así que en una serie se eligen otra vez los mismos personajes de la biblioteca en cada episodio.
Editas una línea y solo esa línea se vuelve a sintetizar; todo lo demás conserva el audio que ya tenía. En un proyecto largo, esa es la diferencia entre revisar con libertad y temerle a cada reescritura: tres líneas cambiadas cuestan tres líneas de generación, no un renderizado completo.
Un MP3 mezclado en todos los planes, las pistas separadas por personaje en un ZIP para musicalizar y diseñar sonido en Pro, y desde Plus un SRT generado desde tu guion en lugar de transcrito, así que los nombres quedan bien escritos y los tiempos ya coinciden.
Cópialo como texto. No hay que reformatear nada ni llenar ninguna plantilla.
Mira la voz propuesta para cada personaje, escucha alternativas sobre la misma línea y deja fija la que encaje.
Dale a cada personaje una emoción por defecto. Casi toda la escena va a correr con ese valor.
Marca las líneas concretas donde se quiebra el registro: normalmente tres a cinco por escena.
Los problemas de ritmo no se ven línea por línea y saltan a la vista de principio a fin.
Mezcla, pistas separadas o subtítulos, según a dónde vaya el audio después.
La síntesis de voz ya es un bien común. Varios proveedores producen audio lo bastante bueno para un audiodrama, y la distancia entre ellos es menor que la distancia entre una escena bien repartida y una mal repartida. Lo que no es un bien común es todo lo que rodea a la síntesis: averiguar quién habla, mantener a un personaje estable durante meses, dirigir líneas sueltas y sacar el audio en un formato con el que se pueda mezclar.
Por eso aquí la capa de proveedor es una interfaz con varias implementaciones detrás. Si el año que viene aparece un motor mejor, eso es un cambio de configuración y no una reconstrucción, y tus proyectos, tu reparto y tu dirección por línea pasan intactos.
No escribe guiones. Diálogo generado interpretado por voces generadas es un producto que nadie ha pedido dos veces, y el problema interesante del audiodrama es la producción, no las ideas.
No mezcla. Nada de camas musicales, ni reverberación, ni ubicación estéreo. Eso va en un editor de audio, donde puedes oírlo todo junto; meterlo dentro de una herramienta de renderizado ha dado siempre algo peor que cualquiera de las dos cosas por separado.
No superpone diálogos en un mismo renderizado. Hablar encima de alguien es un recurso dramático real y es una operación de mezcla: exporta las pistas separadas y muévelas. Un arrastre en cualquier editor, y es lo más realista que le puedes hacer a una discusión.
La vocalización física es el límite actual: gritos, llanto, reírse mientras se habla, gruñidos de esfuerzo. Son eventos de respiración más que eventos de habla, y son el punto donde quien escucha identifica el audio como generado. Escribe esquivándolos cuando puedas, y graba las dos o tres líneas que los sostienen cuando no puedas. Mezclar audio grabado y generado en una misma producción es normal —se hace en tu editor de audio, porque las grabaciones no se pueden meter en un proyecto—, y la costura no se nota cuando la escritura sostiene el momento.
Los monólogos emocionales muy largos son el segundo punto flojo, por un motivo parecido: una persona que interpreta toma una decisión sobre el subtexto cada pocos segundos a lo largo de un monólogo, y aquí nada intenta eso.
Ninguno: no hay subida de archivos. Pega el texto directamente, en formato de guion cinematográfico, en líneas con «Nombre:» o en prosa con diálogo marcado. Si lo tienes en un documento de Word o en un archivo de subtítulos, copia el texto y pégalo.
En los formatos de guion, casi siempre. En prosa depende de qué tan explícita sea la atribución: los intercambios largos sin acotación y los personajes nombrados por un epíteto son los casos donde falla de forma sistemática. Revisar las asignaciones antes de renderizar lleva un minuto.
Sí, y es lo que vuelve posibles los proyectos largos. Cambias una línea, vuelves a renderizar esa línea, y todo lo demás conserva el audio que ya tenía.
No. Un personaje existe solo dentro de su proyecto. Para una serie, crea un proyecto nuevo por episodio, elige los mismos personajes de la biblioteca y escribe los mismos perfiles. No está garantizada la misma voz entre proyectos, porque las voces se reparten para que no se repitan según el orden en que se agregan los personajes dentro de cada proyecto, así que escucha la primera línea de tu protagonista antes de exportar.
Aquí no. Exporta las pistas separadas y musicalízalas en un editor de audio. Es un límite puesto a propósito, no una función que falte.
Solo Pro. En Free, Basic y Plus cada línea sigue la emoción de base de su personaje, que sí se puede fijar en todos los planes: alcanza para comprobar que una escena funciona, pero no para colocar un giro concreto en una línea concreta.
Pega un guion, deja que CastDub le dé una voz propia a cada personaje y exporta un audiodrama terminado.
Empieza gratisSin tarjeta. Free te da una bolsa única de créditos.