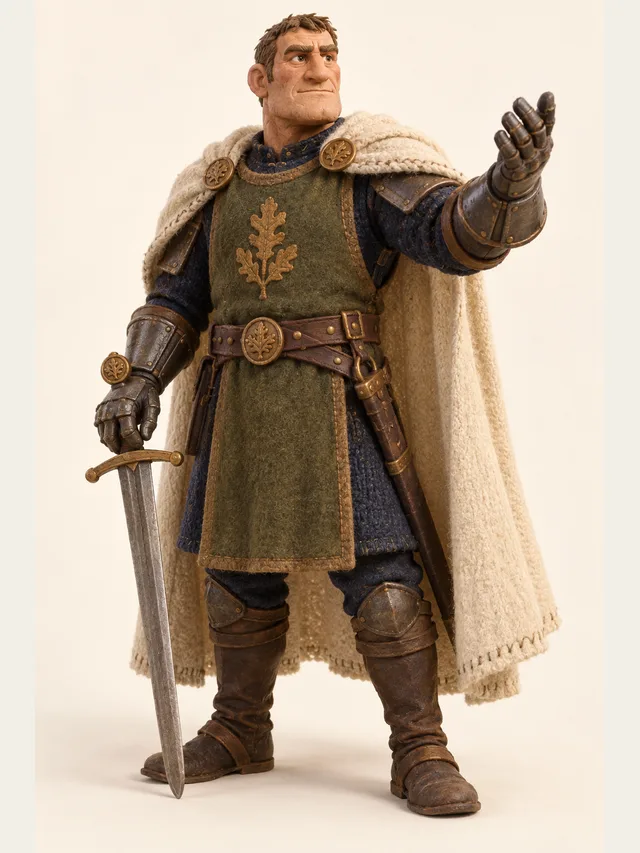
Torvald
Knight commander who gives orders that men actually follow
Produkt
Das hier ist das Produkt. Alles andere auf dieser Seite ist nur eine Tür dorthin. Du bringst ein Skript mit mehr als einer Person darin; CastDub findet heraus, wer diese Personen sind, gibt jeder eine Stimme und legt dir die Regler in die Hand, mit denen sonst eine Regie arbeitet.
Torvald
Knight commander who gives orders that men actually follow
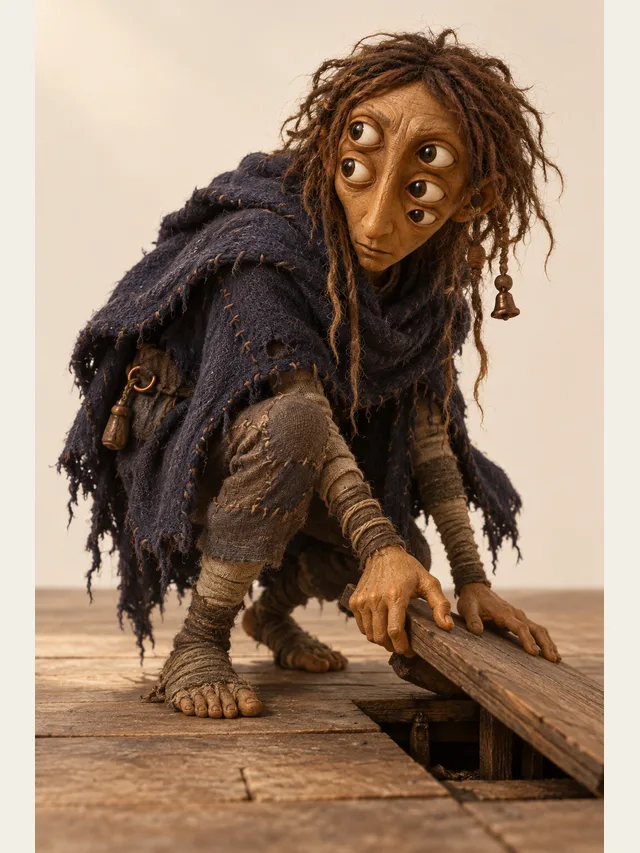
Morrow
Something under the floorboards that learned your name
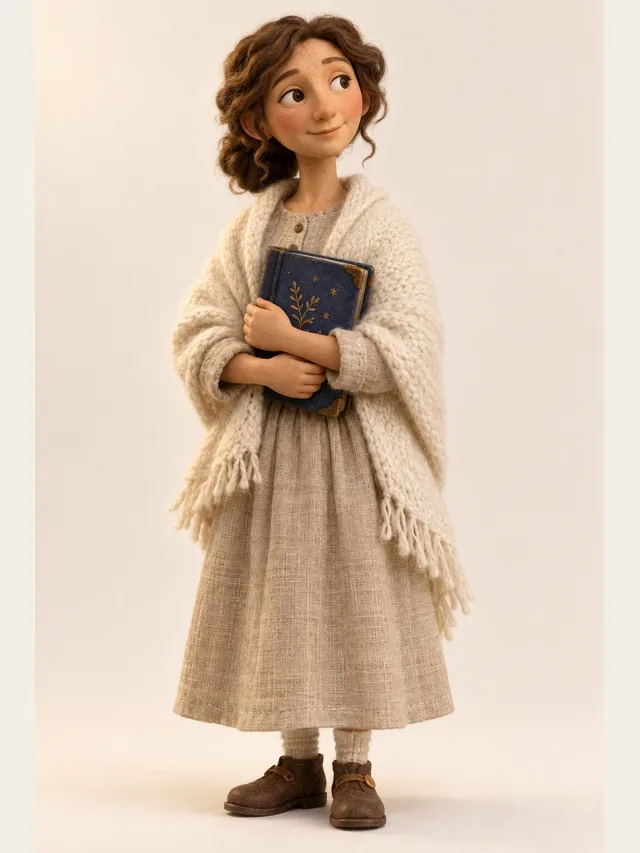
Wren
Bedtime-story narrator, slow and warm, never wakes anyone up
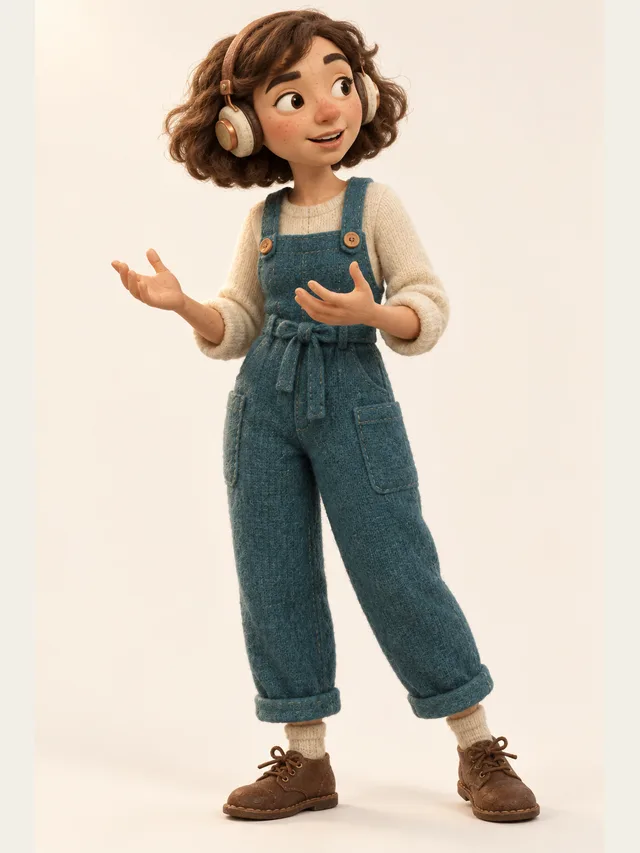
Juno
Podcast host who thinks out loud and never reads a script
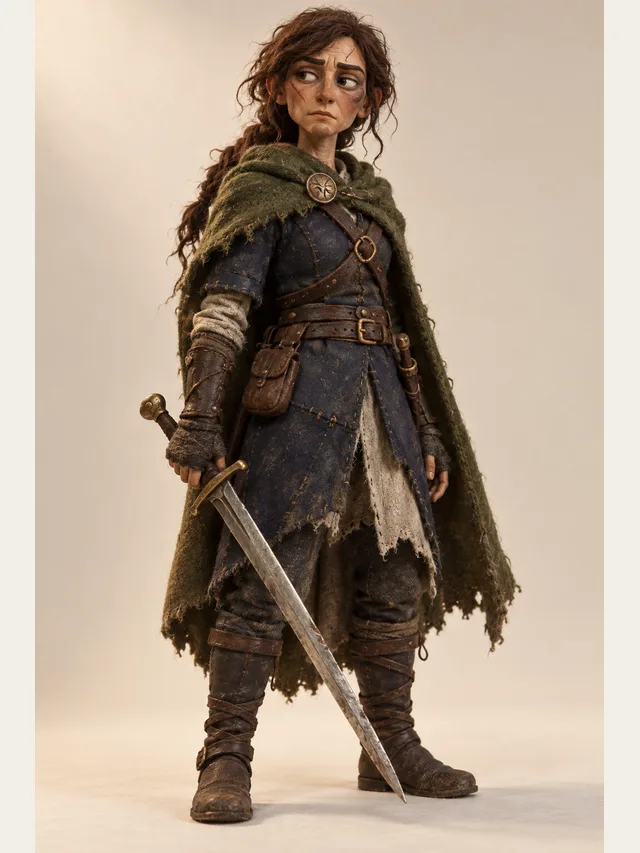
Kestrel
Low, weary swordswoman who has already lost this war once
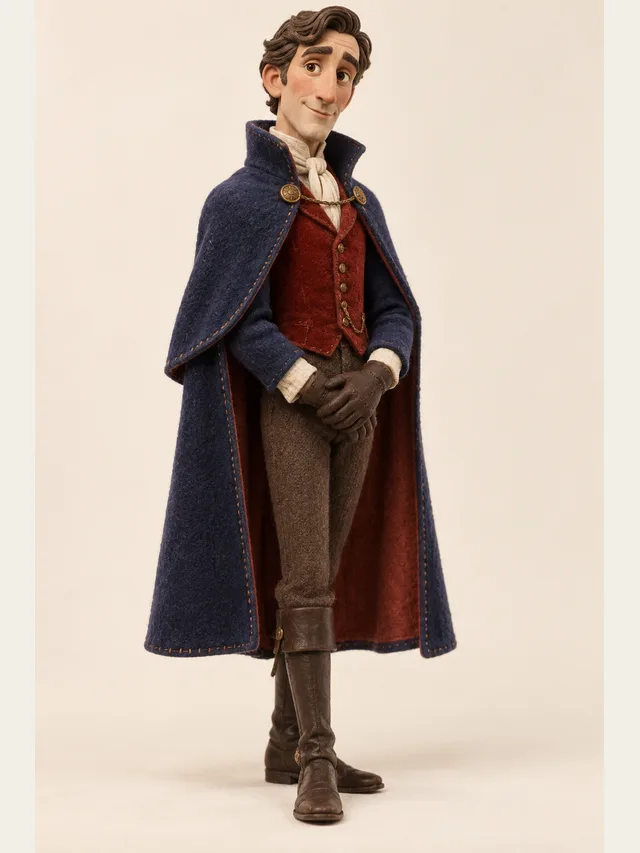
Ashford
Velvet-voiced villain who apologises before he ruins you
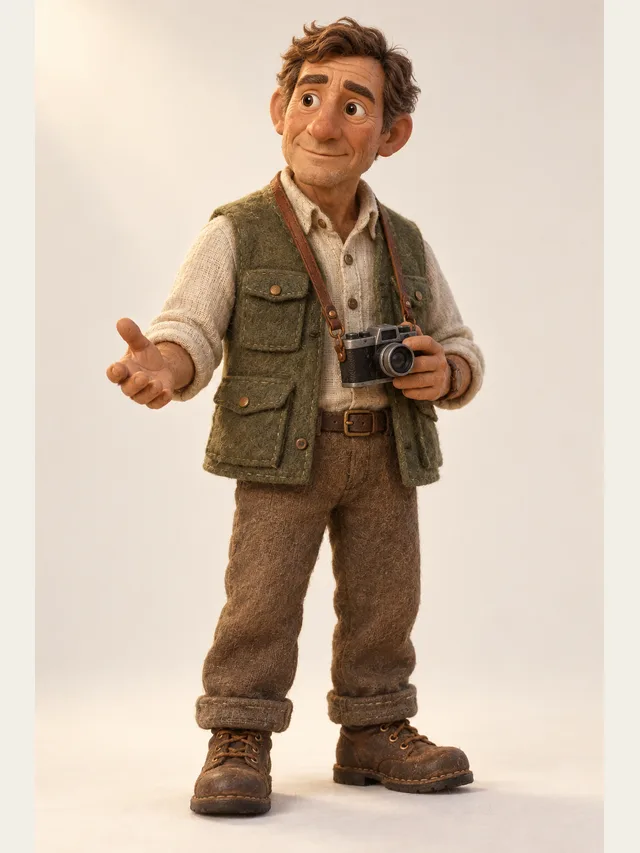
Hale
Documentary narrator with a hand on the listener's shoulder
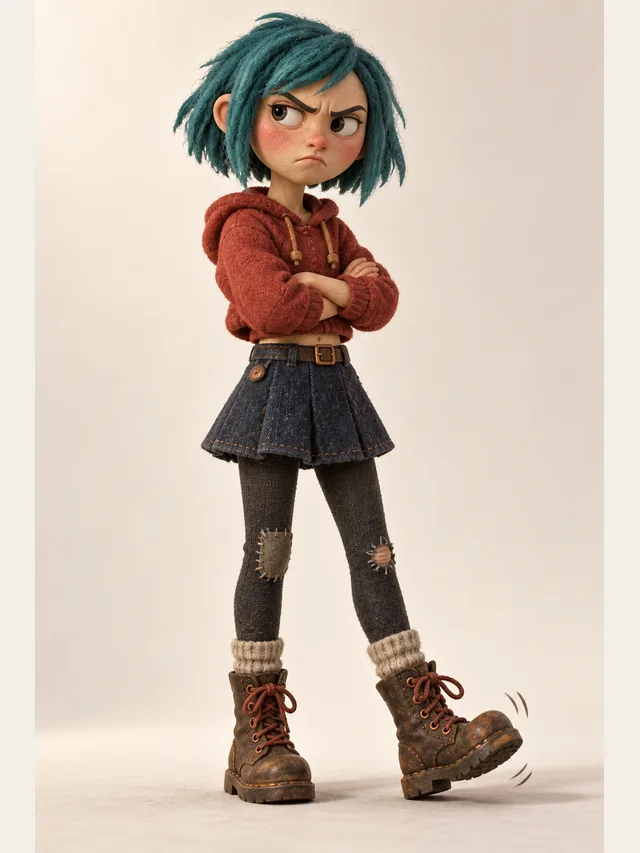
Cass
Seventeen and furious about it, in a good way
Drehbuchformat, Zeilen mit „Name:“ davor und normale Prosa mit Redebegleitsätzen werden so gelesen, wie sie dastehen. Füg sie aus einem Dokument, einer Drehbuch-App oder einer Tabellenspalte ein. Einen Datei-Upload gibt es nicht – .txt-, .docx- und .srt-Dateien werden nicht importiert, also kopier den Text hinein.
Die Sprechererkennung teilt das Skript danach auf, wer gerade redet, und schlägt dann für jede sprechende Figur einen Bibliotheks-Charakter vor – passend dazu, wie das Skript sie zeigt. Das ist ein Vorschlag, keine Entscheidung: Jede Zuweisung lässt sich überschreiben, und eine Überschreibung hält für den Rest des Projekts.
Emotion gehört zur Zeile, nicht zur Figur. Gib jeder Figur eine Grundlage und markiere nur die Zeilen, an denen sie bricht. Das ist der eine Mechanismus, der eine Leseprobe von einer Aufführung trennt – und das Wichtigste, was Pro dazubringt: In den anderen Tarifen folgt jede Zeile der Grundlage ihrer Figur.
Name, Kurzprofil, Geschlecht, Altersgruppe, Bibliotheks-Charakter und Grundemotion – einmal im Projekt festgelegt. Zwei Figuren in einem Projekt teilen sich keine Stimme, solange noch eine der zehn Grundstimmen frei ist – mehr als zehn klar unterscheidbare Stimmen hat ein Projekt nicht –, und eine später hinzugefügte Figur wirbelt die übrigen nicht durcheinander. Figuren wandern nicht von Projekt zu Projekt; eine Serie wählt in jeder Folge dieselben Bibliotheks-Charaktere neu.
Änderst du eine Zeile, wird nur diese Zeile neu synthetisiert; alles andere behält sein vorhandenes Audio. Bei einem langen Projekt ist das der Unterschied zwischen freiem Überarbeiten und der Angst vor jeder Umschreibung – drei geänderte Zeilen kosten drei Zeilen Erzeugung, keinen kompletten Neu-Render.
Ein fertiger Mix als MP3 in jedem Tarif, Einzelspuren pro Figur als ZIP für Musik und Sounddesign in Pro, und ab Plus eine SRT, die aus deinem Skript entsteht statt aus einer Transkription – Namen stehen richtig da, und die Zeiten passen schon.
Kopier es als Text hinein. Kein Umformatieren, keine Vorlage zum Ausfüllen.
Sieh dir die vorgeschlagene Stimme je Figur an, hör Alternativen an derselben Zeile und leg fest, was sitzt.
Gib jeder Figur eine Standard-Emotion. Der größte Teil der Szene läuft auf diesem Wert.
Markiere die Zeilen, an denen die Grundlage bricht – meist drei bis fünf pro Szene.
Tempoprobleme sind Zeile für Zeile unsichtbar und am Stück offensichtlich.
Mix, Stems oder Untertitel, je nachdem, wohin das Audio als Nächstes geht.
Sprachsynthese ist inzwischen Massenware. Mehrere Anbieter liefern Audio, das für ein Hörspiel gut genug ist, und der Abstand zwischen ihnen ist kleiner als der zwischen einer gut und einer schlecht besetzten Szene. Nicht Massenware ist alles um die Synthese herum: herauszufinden, wer spricht, eine Figur über Monate stabil zu halten, einzelne Zeilen zu führen und Audio in einer Form herauszubekommen, mit der sich mischen lässt.
Deshalb ist die Anbieterschicht hier eine Schnittstelle mit mehreren Implementierungen dahinter. Taucht nächstes Jahr eine bessere Engine auf, ist das eine Konfigurationsänderung und kein Neubau – und deine Projekte, deine Besetzung und deine Regie pro Zeile wandern unverändert mit.
Es schreibt keine Skripte. Erzeugte Dialoge, gesprochen von erzeugten Stimmen, sind ein Produkt, nach dem niemand ein zweites Mal fragt – und das interessante Problem am Hörspiel ist die Produktion, nicht die Idee.
Es mischt nicht. Keine Musikbetten, kein Hall, keine Stereopositionierung. Das gehört in einen Audio-Editor, in dem du alles zusammen hörst; in ein Render-Werkzeug eingefaltet kommt dabei zuverlässig etwas heraus, das schlechter ist als beides.
Es legt Dialoge nicht in einem einzigen Render übereinander. Jemandem ins Wort zu fallen ist ein echtes dramatisches Mittel und zugleich eine Mischaufgabe – exportier die Stems und schieb sie gegeneinander. Ein Zug in irgendeinem Editor, und es ist das Realistischste, was du mit einem Streit anstellen kannst.
Körperliche Lautäußerungen sind die aktuelle Grenze: Schreien, Schluchzen, Lachen beim Sprechen, Ächzen unter Anstrengung. Das sind Atem-Ereignisse und keine Sprech-Ereignisse, und genau dort erkennt ein Publikum Audio als erzeugt. Schreib drumherum, wo es geht, und nimm die zwei, drei Zeilen selbst auf, wo es nicht geht. Aufgenommenes und erzeugtes Audio in einer Produktion zu mischen ist normal – das passiert in deinem Audio-Editor, denn Aufnahmen lassen sich nicht in ein Projekt holen –, und die Naht hört man nicht, wenn der Text den Moment trägt.
Sehr lange emotionale Monologe sind die zweite Schwachstelle, aus einem verwandten Grund: Ein Mensch trifft über einen Monolog hinweg alle paar Sekunden eine Entscheidung über den Subtext, und nichts hier versucht das.
Keine – einen Datei-Upload gibt es nicht. Füg den Text selbst ein, im Drehbuchformat, als „Name:“-Zeilen oder als Prosa mit Redebegleitsätzen. Aus einem Word-Dokument oder einer Untertiteldatei kopierst du den Text heraus und fügst ihn ein.
In Skriptformaten fast immer. In Prosa hängt es davon ab, wie deutlich du zuschreibst – lange Wortwechsel ohne Zuschreibung und Figuren, die nur mit Beinamen benannt werden, sind die verlässlichen Fehlerfälle. Die Zuweisungen vor dem Rendern zu überfliegen kostet eine Minute.
Ja, und genau das macht lange Projekte überhaupt möglich. Zeile ändern, diese Zeile neu rendern, alles andere behält sein Audio.
Nein. Eine Figur existiert nur in ihrem Projekt. Für eine Serie legst du pro Folge ein neues Projekt an, wählst dieselben Bibliotheks-Charaktere und schreibst dieselben Kurzprofile. Dieselbe Stimme ist projektübergreifend nicht garantiert, weil Stimmen innerhalb jedes Projekts in der Reihenfolge verteilt werden, in der Figuren dazukommen – hör dir also vor dem Export die erste Zeile deiner Hauptfigur an.
Hier nicht. Exportier die Stems und vertone sie in einem Audio-Editor. Das ist eine bewusste Grenze und keine fehlende Funktion.
Pro. In Free, Basic und Plus folgt jede Zeile der Standard-Emotion ihrer Figur – gut genug, um zu prüfen, ob eine Szene trägt, aber nicht, um einen bestimmten Umschwung auf eine bestimmte Zeile zu legen.
Füge ein Skript ein, lass CastDub jeder Figur eine Stimme geben und exportier ein fertiges Hörspiel.
Kostenlos startenKeine Kreditkarte. Free gibt dir ein einmaliges Guthaben.