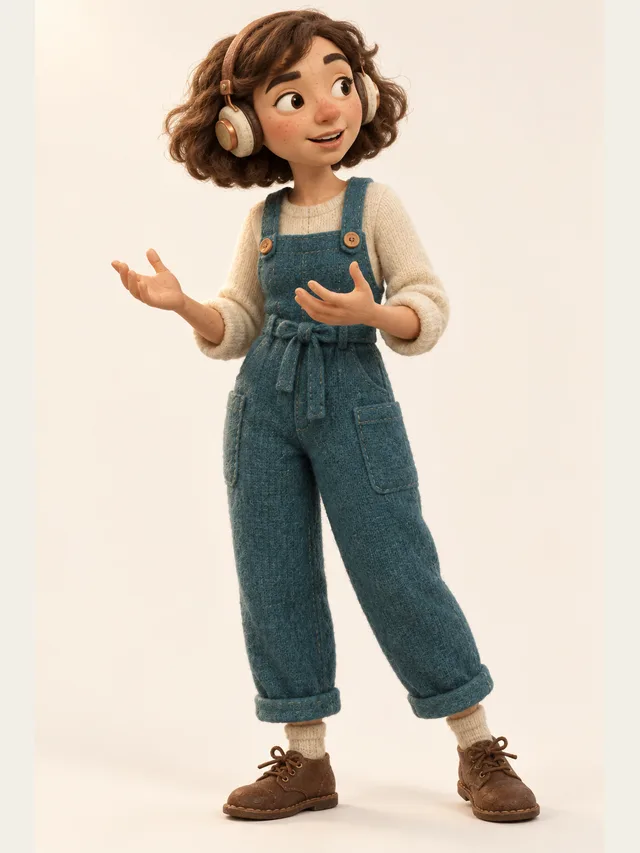
Juno
Apresentadora que pensa em voz alta
Categoria de voz
Podcast roteirizado é o formato que mais combina com voz sintética: escrito antes, consumido só em áudio e quase sempre feito por uma ou duas pessoas sem estúdio. Escale os apresentadores, escale o entrevistado, renderize o episódio.
Juno
Apresentadora que pensa em voz alta
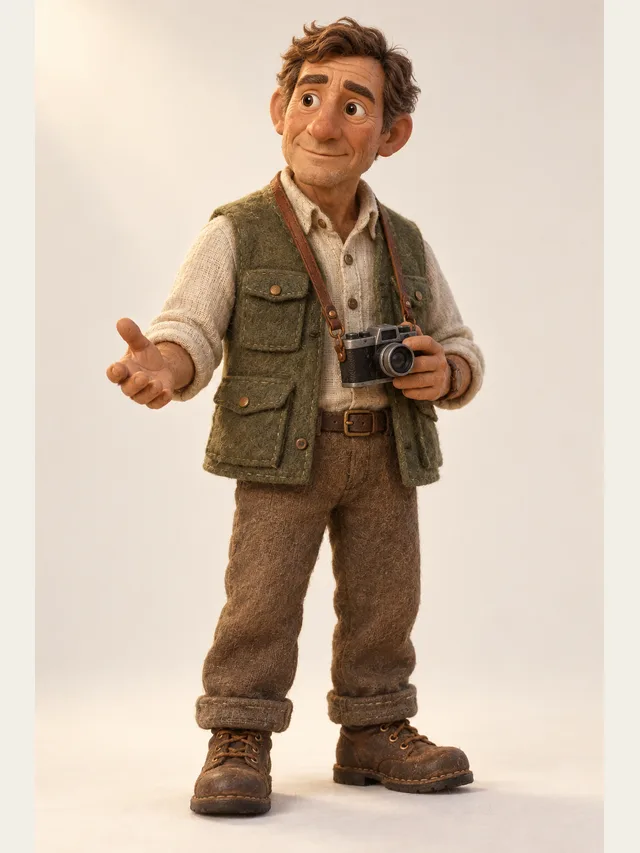
Hale
Narrador dos blocos documentais
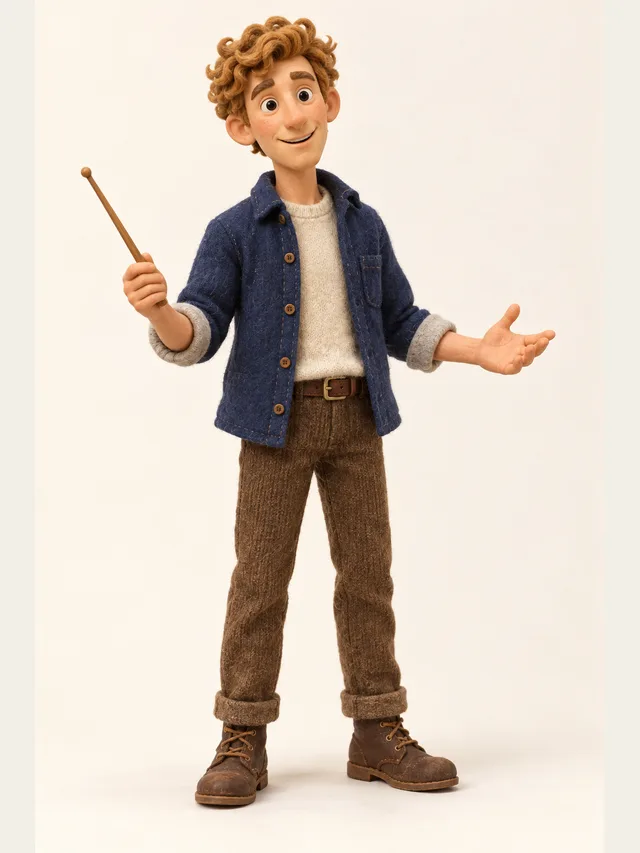
Quill
Coapresentador que nunca soa entediado
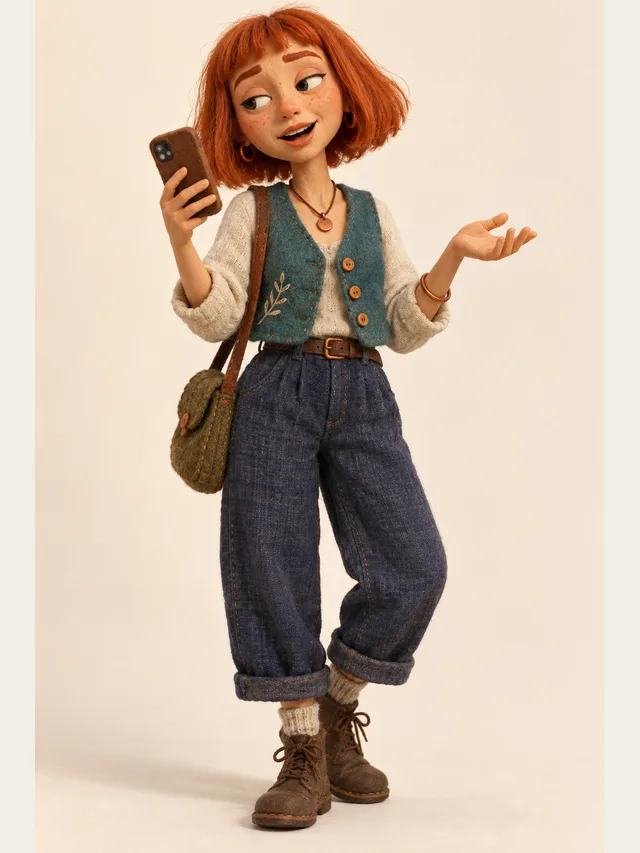
Indie
Rápido, chapado, vagamente debochado
As amostras são provisórias enquanto o áudio de demonstração público é produzido. Toda voz está disponível em todos os planos — a biblioteca não é paywall.
O podcast se divide grosso modo entre programa de conversa, em que duas pessoas falam sem roteiro, e programa roteirizado, em que cada palavra é escrita antes. A segunda metade é onde a voz sintética faz sentido, e é também a metade que o Brasil produz muito menos do que poderia — o país tem um dos maiores públicos de podcast do mundo, e a esmagadora maioria do catálogo é mesa de conversa, porque ficção sonora exige elenco e elenco exige dinheiro.
Dentro do roteirizado, ficção narrativa e contação documental são os encaixes mais fortes. Os dois têm um narrador segurando a estrutura e falas de personagem dentro dela, que é exatamente o formato em que uma voz por personagem muda a experiência em vez de apenas economizar tempo.
A diferença entre fala transcrita e diálogo escrito é visível na página: fala real tem começo falso, palavra repetida, muleta e frase que simplesmente não termina. Diálogo escrito é limpo, e limpeza é exatamente o que denuncia um programa de conversa fabricado.
O conserto é escrever a bagunça. Ponha o “é, não, tipo assim” na página. Dê ao coapresentador interjeições curtas em falas próprias. Termine uma frase no meio e deixe o outro completar. Em português brasileiro tem um marcador que faz muito trabalho sozinho: o “né?” no fim da frase, que é praticamente a assinatura da fala espontânea daqui — usado com moderação, ele convence mais do que qualquer ajuste de ritmo.
Os dados de escuta de podcast são consistentes entre plataformas: as maiores quedas acontecem nos primeiros noventa segundos e nas fronteiras entre blocos. Duas decisões estruturais respondem por quase toda a diferença entre um programa que retém e um que não retém, e nenhuma delas tem a ver com a qualidade da voz.
Troca de voz é subestimada como ferramenta de atenção. Passar de apresentador para narrador, ou introduzir um personagem novo, reinicia a atenção de um jeito que nenhuma mudança de assunto consegue — e é justamente o recurso que um programa de voz única não tem.
Público de podcast é incomumente apegado a apresentador, e é exatamente por isso que apresentador sintético não declarado dá errado quando descoberto. Ponha uma linha nas notas do episódio. O custo é zero e ele elimina a única versão desagradável dessa história.
Existe um limite absoluto: não gere uma voz que soe como uma pessoa real e identificável e a apresente como sendo ela. Isso é falsidade de identidade independentemente da sua intenção, e no ambiente brasileiro, onde áudio encaminhado circula mais do que qualquer outro formato, é a coisa que mais rápido vira problema sério.
A analítica de podcast é brutalmente consistente: a maior queda isolada acontece nos primeiros noventa segundos, e uma vinheta longa de marca no topo do episódio é o jeito mais confiável de provocá-la. A estrutura que retém é conteúdo primeiro — trinta segundos da coisa mais interessante do episódio —, depois a vinheta, depois o corpo.
Isso importa mais num programa gerado do que num gravado, porque a voz sintética tem menos daquele calor incidental que compra alguns segundos de boa vontade para um apresentador humano. Você precisa conquistar a atenção com o texto, não com simpatia.
Diálogo gerado chega limpo e constante, o que parece vantagem e cria um problema específico: ele fica em cima da cama de música em vez de ficar dentro dela. O conserto é o mesmo que a radiodifusão usa há décadas — abaixe a cama sob a fala e acrescente um pouquinho de ruído de sala embaixo do diálogo, para ele ocupar um espaço em vez de flutuar.
As duas coisas são decisões únicas que você salva como modelo. Uma vez definidas, todo episódio se assenta direito sem pensamento adicional, que é exatamente o tipo de problema que vale resolver uma vez só.
Podcast de dois apresentadores é conversa com interrupção, ruído de concordância e frase pela metade. Um ensaio dividido entre duas vozes soa exatamente como um ensaio dividido entre duas vozes.
Apresentadores têm que ser distinguíveis dentro de uma frase, porque o ouvinte não tem rosto para olhar. Escolha faixas de altura diferentes e velocidades de fala diferentes.
Abertura fria, vinheta, blocos do corpo, encerramento. Só as falas que você muda são geradas de novo, então dá para refazer o meio sem tocar no começo — e, se quiser os blocos como arquivos separados, dê a cada um o seu próprio projeto.
A atenção em podcast cai de forma constante. Ponha a entrega de energia mais alta nas transições de bloco, onde o ouvinte decide se fica.
No Pro, leve as faixas por voz para a sua vinheta, as passagens e a cama de música ficarem embaixo do diálogo direito, em vez de brigarem com um arquivo já mixado.
Parte vai, especialmente em formato que finge ser espontâneo, onde o acabamento entrega. Formato narrativo e documental esconde muito melhor, porque o ouvinte já espera uma leitura roteirizada. Declarar nas notas do episódio é honesto e, pela nossa experiência, menos danoso do que ser descoberto.
Principalmente pela escrita. Forma reduzida, começo falso escrito por extenso, interrupção curta e ruído de concordância em fala própria fazem mais do que qualquer ajuste. Em português brasileiro isso significa escrever “tá”, “pra”, “né” e “a gente” do jeito que se fala — texto de podcast escrito na norma culta soa como locução de rádio AM, não como conversa.
Pode, no seu editor de áudio, e é arranjo comum: você apresenta, gera o coapresentador ou os personagens de arquivo. Grave em nível parecido e num cômodo razoavelmente seco e os dois convivem bem.
Gerar entrevista falsa com pessoa real não é aceitável e os nossos termos proíbem. Gerar entrevista com personagem fictício, ou reconstituição histórica dramatizada e claramente rotulada como tal, não tem problema.
A duração do episódio é limitada pelos seus créditos mensais — os caracteres do roteiro, contados a cada exportação — e não por um teto de renderização. O Basic dá sessenta minutos por mês, o que cobre um programa semanal de quinze minutos; os duzentos do Plus cobrem com folga a maior parte dos formatos semanais.
Não estritamente, mas as transições ficam muito mais claras com ela, e diálogo sintético se beneficia da textura. Uma passagem curta entre blocos também disfarça as emendas entre trechos renderizados separadamente.
Cole um roteiro, deixe a CastDub dar uma voz a cada personagem e exporte um audiodrama pronto.
Criar de graçaSem cartão de crédito. O Free dá um bolo único de créditos.