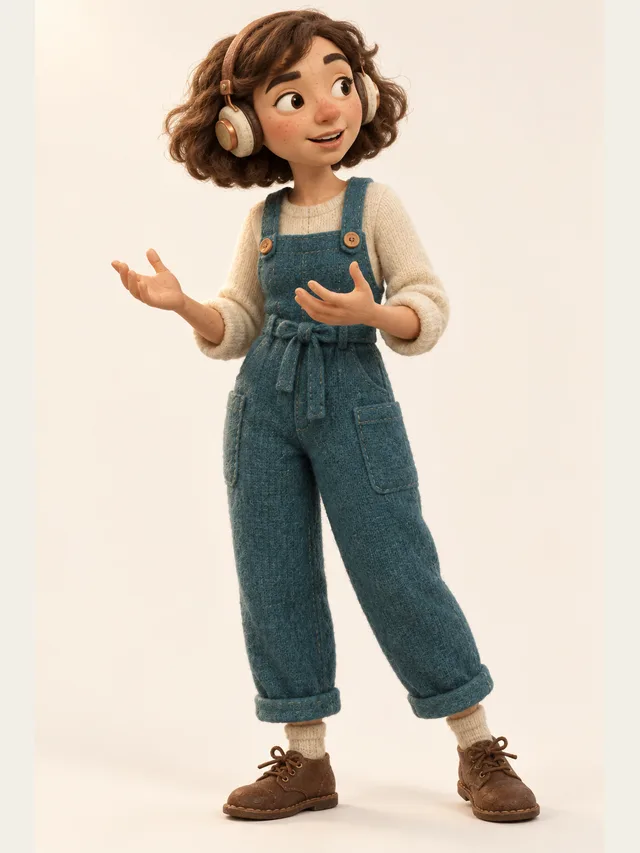
Juno
Host, die laut nachdenkt
Stimmkategorie
Geskriptete Podcasts sind das Format, zu dem synthetische Stimmen am besten passen: vorher geschrieben, rein auditiv konsumiert, meist von ein oder zwei Leuten ohne Studio gemacht. Besetz die Hosts, besetz den Gast, render die Folge.
Juno
Host, die laut nachdenkt
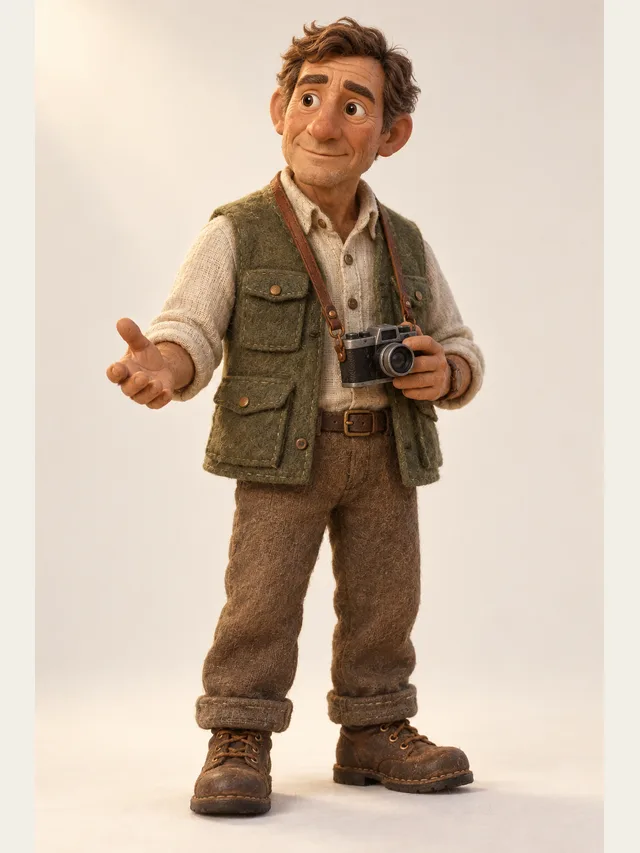
Hale
Erzähler für die Doku-Strecken
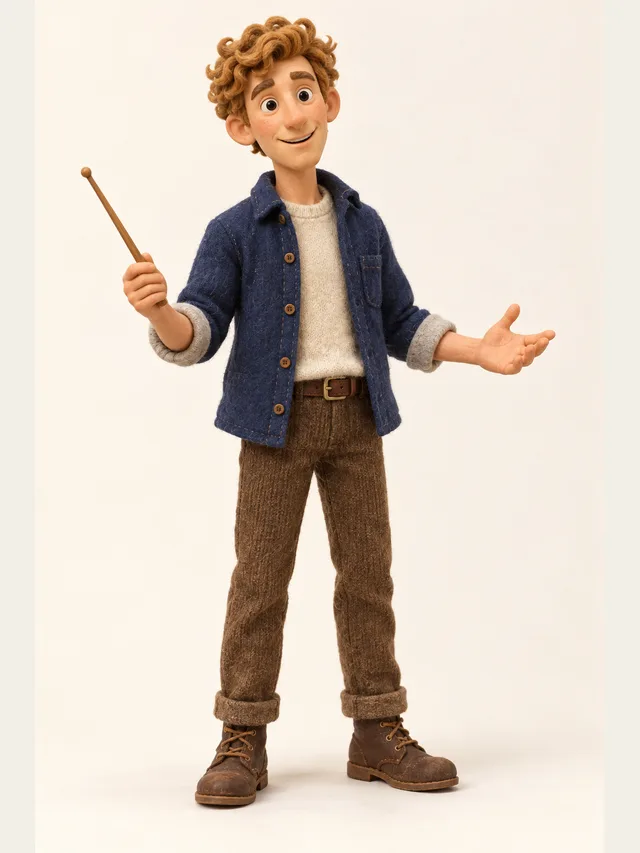
Quill
Co-Host, der nie gelangweilt klingt
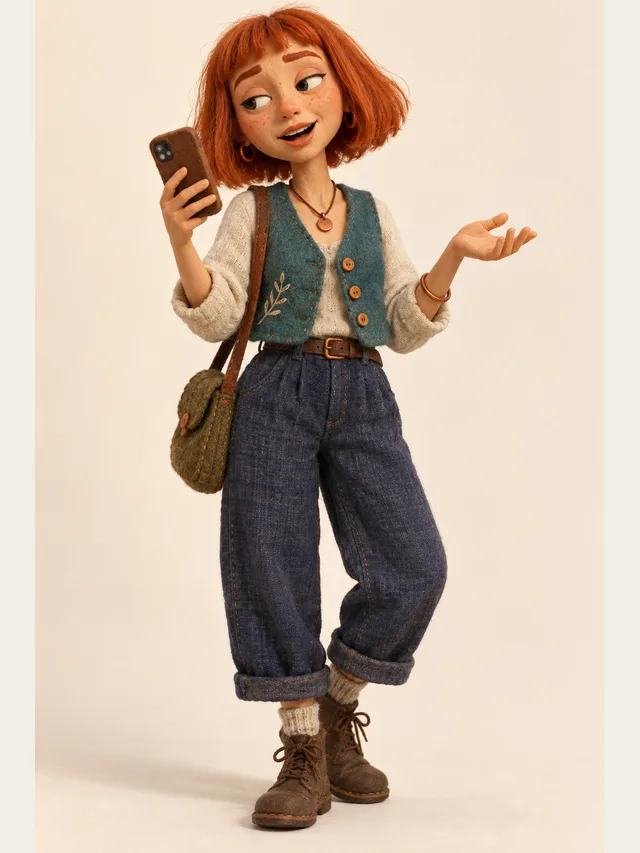
Indie
Schnell, flach, leicht amüsiert
Die Hörproben sind Platzhalter, solange das öffentliche Demo-Audio noch produziert wird. Jede Stimme ist in jedem Tarif verfügbar – die Bibliothek ist keine Bezahlschranke.
Podcasting zerfällt grob in Gesprächsformate, in denen zwei Menschen ohne Skript reden, und geskriptete Formate, in denen jedes Wort vorher geschrieben ist. Für das Erste sind synthetische Stimmen nahezu nutzlos und für das Zweite wirklich gut, denn eine geskriptete Sendung ist bereits die Aufführung eines geschriebenen Textes – genau das, was diese Werkzeuge tun.
Innerhalb des geskripteten Podcastings passen erzählende Fiktion und dokumentarisches Erzählen am besten. Beide haben eine Erzählstimme, die die Struktur hält, und Figuren oder Gesprächspartner, die darin auftauchen, was sich exakt auf einen Ablauf aus Besetzen und Rendern abbilden lässt.
Im deutschsprachigen Raum ist das gerade der Teil des Marktes, der wächst. Fiktionale Podcasts und Hörspielserien haben mit den Mediatheken der Öffentlich-Rechtlichen und den großen Streaming-Anbietern ein Zuhause bekommen, und das Publikum dafür ist durch achtzig Jahre Radiohörspiel bestens vorbereitet.
Der Unterschied zwischen transkribierter Rede und geschriebenem Dialog ist auf dem Papier sichtbar: Echte Rede hat Fehlstarts, Wortwiederholungen, Füllwörter und Sätze, die früh abbrechen. Geschriebener Dialog ist aufgeräumt. Wird ein aufgeräumtes Skript gesprochen, klingt es nach Aufführung – richtig für ein Hörspiel, falsch für einen Gesprächspodcast.
Die Abhilfe ist, die Unordnung mitzuschreiben. Schreib das „ja, nee, also“ hin. Gib dem Co-Host kurze Einwürfe auf eigenen Zeilen. Lass einen Satz früh enden und die andere Person den Gedanken zu Ende bringen. Dafür braucht es keine Funktion, sondern die Entscheidung, es zu schreiben.
Die Hördaten sind über Plattformen hinweg gleich: Die größten Abbrüche passieren in den ersten anderthalb Minuten und an Segmentgrenzen. Daraus folgen zwei Gewohnheiten. Beginn mit Inhalt statt mit einem langen Marken-Intro, und lass jeden Übergang etwas leisten – eine Frage, einen Haken, einen Stimmwechsel.
Stimmwechsel werden als Aufmerksamkeitswerkzeug unterschätzt. Von Host zu Erzähler zu wechseln oder eine neue Figur einzuführen, setzt die Aufmerksamkeit auf eine Weise zurück, die keine Energie innerhalb einer einzigen Stimme erreicht. Eine Besetzung gibt dir diesen Hebel an jeder Segmentgrenze.
Podcast-Publikum hängt ungewöhnlich stark an den Hosts, und genau deshalb geht eine nicht offengelegte synthetische Moderation schlecht aus, wenn sie auffliegt. Eine Zeile in den Shownotes. Sie kostet nichts und verwandelt das Gespräch von Täuschung in Handwerk.
Eine absolute Grenze gibt es: Erzeug keine Stimme, die nach einer realen, identifizierbaren Person klingt, und gib sie nicht als diese aus. Das ist Identitätsmissbrauch, unabhängig von der Absicht, und der schnellste Weg, Sendung und Konto zu verlieren.
Ein langes Marken-Intro am Anfang einer Folge ist die verlässlichste Art, den größten Abbruch zu verursachen. Die Struktur, die Hörende hält, ist Inhalt zuerst – dreißig Sekunden vom Interessantesten der Folge –, dann das Intro, dann der Hauptteil.
Für eine erzeugte Sendung zählt das mehr als für eine aufgenommene, denn einer synthetischen Stimme fehlt die beiläufige Wärme, die einem menschlichen Host ein paar Sekunden Wohlwollen erkauft. Du musst die Aufmerksamkeit über den Text verdienen statt über Persönlichkeit.
Erzeugter Dialog kommt sauber und gleichmäßig an, was nach einem Vorteil klingt und ein bestimmtes Problem schafft: Er sitzt auf einem Musikbett statt darin. Die Abhilfe ist dieselbe, die der Rundfunk seit Jahrzehnten nutzt – das Bett unter der Sprache absenken und ein sehr kleines Maß an Raumton unter den Dialog legen, damit er einen Ort einnimmt statt zu schweben.
Beides sind einmalige Entscheidungen, die du als Vorlage speichern kannst. Einmal gesetzt, sitzt jede Folge ohne weiteres Nachdenken richtig – genau die Sorte Problem, die man einmal löst.
Ein Zwei-Host-Podcast ist ein Gespräch mit Unterbrechungen, Zustimmungslauten und halbfertigen Sätzen. Ein auf zwei Stimmen verteilter Aufsatz klingt exakt wie ein auf zwei Stimmen verteilter Aufsatz.
Hosts müssen innerhalb eines Satzes unterscheidbar sein, denn das Publikum sieht keine Gesichter. Nimm verschiedene Tonlagen und verschiedene Sprechtempi.
Kaltstart, Intro, Hauptteile, Outro. Neu erzeugt werden nur die Zeilen, die du änderst, also kannst du die Mitte überarbeiten, ohne den Anfang anzufassen – und willst du Segmente als getrennte Dateien, gib jedem ein eigenes Projekt.
Die Aufmerksamkeit in Podcasts fällt stetig. Setz deine energischste Zustellung an die Segmentübergänge, an denen entschieden wird, ob jemand bleibt.
Nimm in Pro die Stems pro Stimme, damit Titelmusik, Stinger und Betten richtig unter dem Dialog sitzen, statt gegen eine fertig gemischte Datei zu kämpfen.
Manche ja, vor allem in Formaten, die spontan wirken sollen und durch ihre Politur auffliegen. Erzählende und dokumentarische Formate verbergen es viel besser, weil dort ohnehin eine geskriptete Lesung erwartet wird. Es in den Shownotes offenzulegen ist ehrlich und nach unserer Erfahrung weniger schädlich, als ertappt zu werden.
Vor allem über den Text. Verkürzungen, ausgeschriebene Fehlstarts, kurze Unterbrechungen und Zustimmungslaute auf eigenen Zeilen leisten mehr als jede Einstellung. Das Problem des polierten Aufsatzes ist ein Skriptproblem, kein Stimmproblem. Im Deutschen hilft zusätzlich, die Modalpartikeln nicht wegzulektorieren: „ja“, „halt“, „eben“, „doch mal“ sind genau das, was geschriebenes Deutsch tilgt und gesprochenes braucht.
Ja, in deinem Audio-Editor, und das ist ein häufiger Aufbau: selbst moderieren, den Co-Host oder die historischen Figuren erzeugen. Nimm mit ähnlichem Pegel und in einem halbwegs trockenen Raum auf, dann sitzen beide gut nebeneinander.
Ein erfundenes Interview mit einer realen Person zu erzeugen ist nicht zulässig und von unseren Bedingungen ausgeschlossen. Ein Interview mit einer fiktiven Figur oder eine deutlich als solche gekennzeichnete historische Nachstellung ist in Ordnung – Letzteres ist im deutschen Feature seit Langem eine etablierte Form, solange die Kennzeichnung klar ist.
Die Folgenlänge begrenzt dein Monatsguthaben – die Zeichen des Skripts, gezählt bei jedem Export –, nicht eine Obergrenze pro Render. Basic gibt 60 Minuten im Monat, was für eine wöchentliche Viertelstunde reicht; die 200 Minuten von Plus decken die meisten wöchentlichen Formate bequem.
Zwingend nicht, aber Übergänge werden damit viel klarer, und erzeugter Dialog profitiert von der zusätzlichen Textur. Ein kurzer Stinger zwischen Segmenten deckt außerdem die Nähte zwischen getrennt gerenderten Teilen.
Füge ein Skript ein, lass CastDub jeder Figur eine Stimme geben und exportier ein fertiges Hörspiel.
Kostenlos startenKeine Kreditkarte. Free gibt dir ein einmaliges Guthaben.