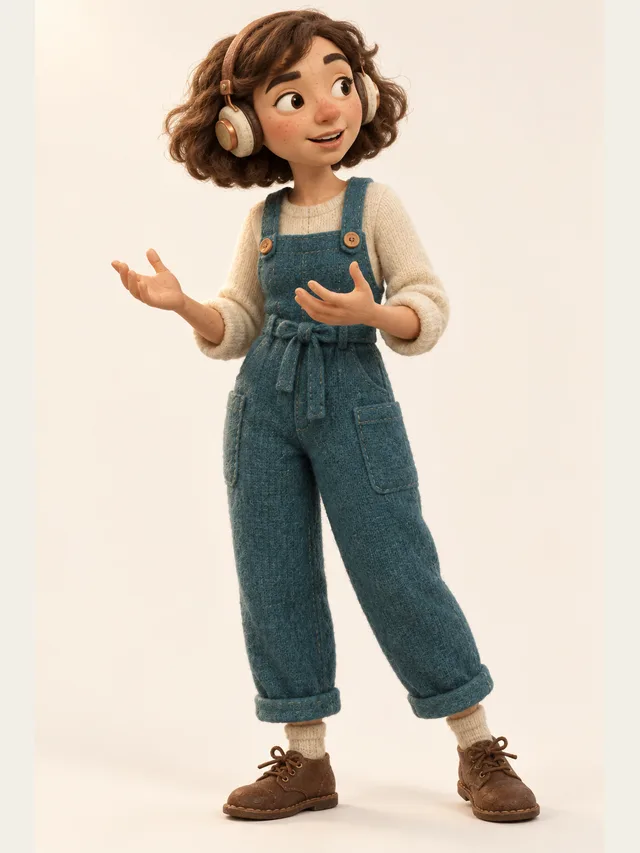
Juno
Animatrice qui réfléchit à voix haute
Catégorie de voix
Le podcast narratif est le format auquel les voix de synthèse conviennent le mieux : écrit à l'avance, consommé en audio seul, et fabriqué le plus souvent par une ou deux personnes sans studio. Distribuez les animateurs, distribuez l'invité, rendez l'épisode.
Juno
Animatrice qui réfléchit à voix haute
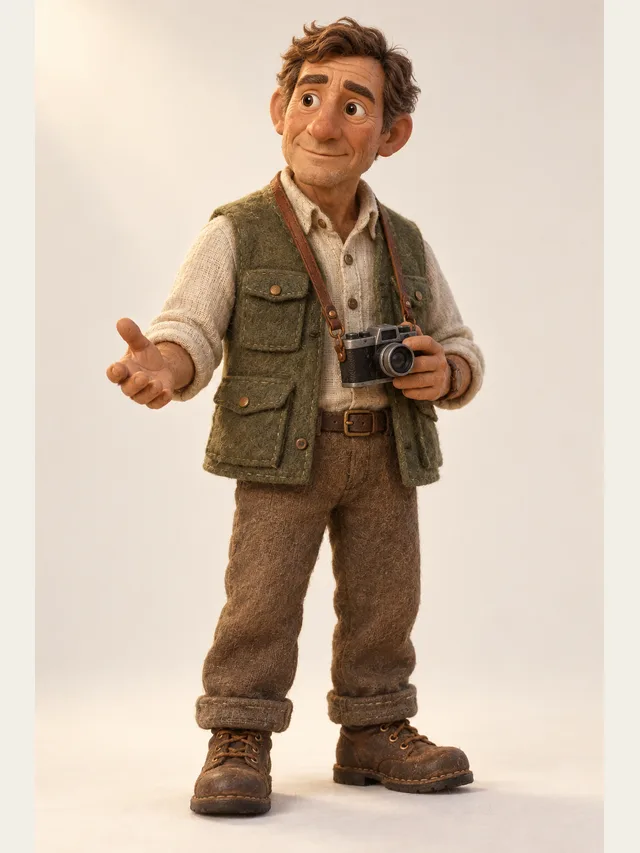
Hale
Narrateur pour les séquences documentaires
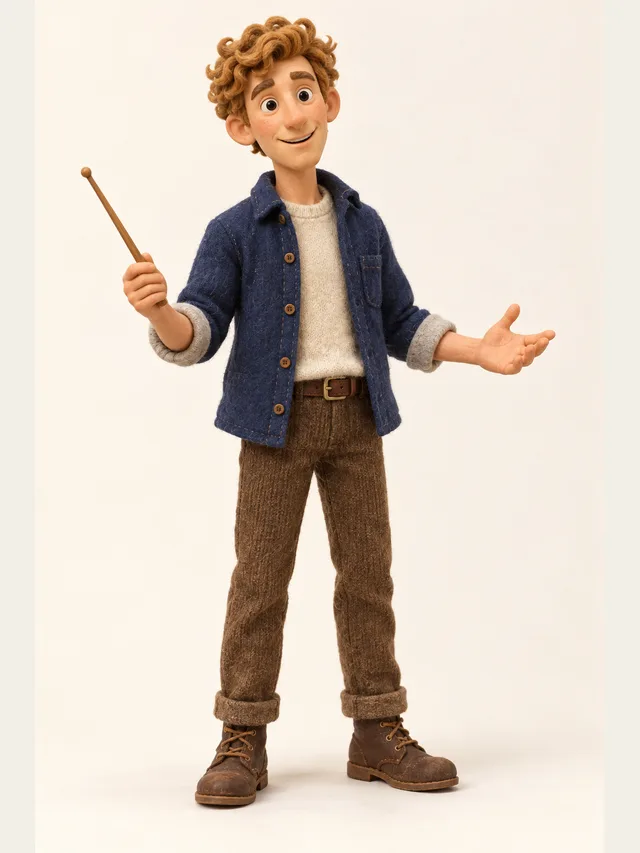
Quill
Co-animateur qui n'a jamais l'air de s'ennuyer
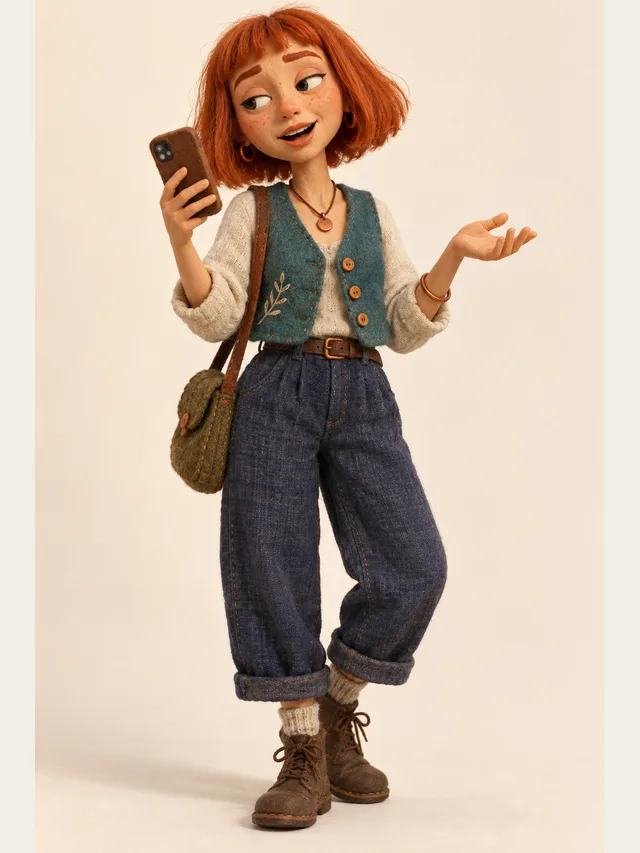
Indie
Rapide, plate, vaguement amusée
Les extraits sont provisoires, le temps que l'audio de démonstration publique soit produit. Toutes les voix sont disponibles dans toutes les formules : la bibliothèque n'est pas un mur payant.
Le podcast se partage grossièrement entre les émissions de conversation, où deux personnes parlent sans script, et les émissions écrites, où chaque mot est rédigé à l'avance. Les voix de synthèse sont à peu près inutiles pour les premières et réellement bonnes pour les secondes, parce qu'une émission écrite est déjà l'interprétation d'un texte — exactement ce que font ces outils.
Dans le podcast écrit, la fiction narrative et le documentaire raconté sont les meilleurs terrains. Les deux ont un narrateur qui tient la structure et des personnages ou des intervenants qui apparaissent à l'intérieur, ce qui correspond exactement à un flux de distribution puis de rendu.
C'est aussi le segment le plus vivant du podcast francophone : les studios indépendants qui ont installé le format narratif l'ont fait avec de très petites équipes, et la fiction sonore a retrouvé un public en podcast bien plus vite qu'à la radio.
La différence entre de la parole transcrite et du dialogue écrit se voit sur la page : la parole réelle a des faux départs, des mots répétés, du remplissage et des phrases qui s'arrêtent en route. Le dialogue écrit est propre. Quand un script propre est interprété, cela sonne comme une interprétation — parfait pour la fiction, faux pour un podcast de conversation.
Le remède, c'est d'écrire le désordre. Mettez les « oui, enfin, je veux dire » sur la page. Donnez au co-animateur de courtes interjections sur leurs propres lignes. Terminez une phrase trop tôt et laissez l'autre finir la pensée. Rien de tout cela ne demande une fonctionnalité ; cela demande de décider de l'écrire.
Les données d'écoute des podcasts sont constantes d'une plateforme à l'autre : les plus grosses chutes se produisent dans les quatre-vingt-dix premières secondes et aux frontières de séquences. Deux habitudes en découlent. Commencez par du contenu plutôt que par un long générique de marque, et faites travailler chaque transition — une question, une accroche, un changement de voix.
Les changements de voix sont sous-estimés comme outils d'attention. Passer de l'animateur au narrateur, ou introduire un nouveau personnage, relance l'attention d'une manière qu'aucune quantité d'énergie dans une voix unique ne peut égaler. Une distribution vous donne ce levier à chaque frontière de séquence.
Les audiences de podcast sont inhabituellement attachées aux animateurs, ce qui explique précisément pourquoi les voix synthétiques non déclarées tournent mal quand elles sont découvertes. Mettez une ligne dans la description. Cela ne coûte rien et cela transforme la conversation, de la tromperie vers le métier.
Il y a une limite absolue : ne présentez jamais une voix générée comme celle d'une personne réelle et identifiable. C'est une usurpation quelle que soit l'intention, et c'est le moyen le plus rapide de perdre à la fois une émission et un compte.
Les statistiques de podcast sont brutalement constantes : la plus grosse chute unique se produit dans les quatre-vingt-dix premières secondes, et un long générique de marque en tête d'épisode est le moyen le plus fiable de la provoquer. La structure qui retient, c'est le contenu d'abord — trente secondes de ce qu'il y a de plus intéressant dans l'épisode — puis le générique, puis le corps.
Cela compte plus pour une émission générée que pour une émission enregistrée, parce qu'une voix de synthèse a moins de cette chaleur accidentelle qui achète quelques secondes d'indulgence à un animateur humain. Vous devez gagner l'attention par l'écriture plutôt que par la personnalité.
Le dialogue généré arrive propre et régulier, ce qui ressemble à un avantage et crée un problème précis : il se pose sur une nappe musicale au lieu d'être dedans. Le remède est celui que la radio emploie depuis des décennies — faire baisser la nappe sous la parole, et ajouter une toute petite quantité de bruit de salle sous le dialogue pour qu'il occupe un espace au lieu de flotter.
Les deux sont des décisions à prendre une fois, que vous pouvez enregistrer comme un modèle. Une fois réglées, chaque épisode se pose correctement sans y repenser, ce qui est exactement le genre de problème qu'il vaut la peine de résoudre une seule fois.
Un podcast à deux animateurs est une conversation avec des interruptions, des acquiescements et des phrases inachevées. Un article coupé en deux voix sonne exactement comme un article coupé en deux voix.
Les animateurs doivent être distinguables dès la première phrase, parce que l'auditeur n'a pas de visages à regarder. Choisissez des bandes de hauteur différentes et des vitesses d'élocution différentes.
Amorce, générique, séquences de corps, conclusion. Seules les répliques modifiées sont régénérées : vous pouvez donc retravailler le milieu sans toucher au début — et si vous voulez des séquences en fichiers séparés, donnez à chacune son propre projet.
L'attention en podcast décroît régulièrement. Placez votre jeu le plus énergique aux transitions de séquence, là où les auditeurs décident de rester ou non.
Avec Pro, prenez les pistes par voix pour que votre générique, vos virgules sonores et vos nappes se posent correctement sous le dialogue au lieu de se battre avec un fichier déjà mixé.
Certains oui, surtout dans les formats qui imitent la conversation libre, où le lissage trahit. Les formats narratifs et documentaires le dissimulent bien mieux, parce que l'auditeur s'attend à une lecture écrite. Le signaler dans la description est à la fois honnête et, d'expérience, moins dommageable que d'être découvert.
Surtout par l'écriture. Les élisions familières, les faux départs écrits noir sur blanc, les courtes interruptions et les acquiescements sur leur propre ligne font plus que n'importe quel réglage. Le problème de l'article trop lisse est un problème de script, pas de voix.
Oui, dans votre éditeur audio, et c'est une configuration courante : vous animez, vous générez le co-animateur ou les personnages d'archives. Enregistrez à un niveau comparable et dans une pièce raisonnablement mate, et les deux cohabitent sans problème.
Fabriquer un faux entretien avec une personne réelle est inacceptable et nos conditions l'interdisent. Générer un entretien avec un personnage de fiction, ou une reconstitution historique clairement annoncée comme telle, ne pose aucun problème.
La durée est limitée par vos crédits mensuels — les caractères du script, recomptés à chaque export — et non par un plafond par rendu. Basic donne 60 minutes par mois, ce qui couvre une émission hebdomadaire d'un quart d'heure ; les 200 de Plus couvrent confortablement la plupart des formats hebdomadaires.
Pas strictement, mais les transitions sont bien plus lisibles avec, et un dialogue synthétique gagne à cette texture. Une courte virgule sonore entre les séquences couvre aussi les raccords entre des sections rendues séparément.
Collez un script, laissez CastDub donner sa voix à chaque personnage, et exportez une fiction sonore finie.
Créer gratuitementSans carte bancaire. Free vous donne une réserve unique de crédits.