Hörspiel-Werkbank für viele Stimmen
Kostenlose KI-Stimmen – jede Figur mit eigener Stimme
Text-to-Speech für die ganze Besetzung. Füge eine Szene ein: CastDub erkennt, wer spricht, gibt jeder Figur eine eigene Stimme, lässt dich die Emotion Zeile für Zeile führen und exportiert einen fertigen Mix. Kostenlos, ohne Kreditkarte – probier unten eine Szene aus, ganz ohne Anmeldung.
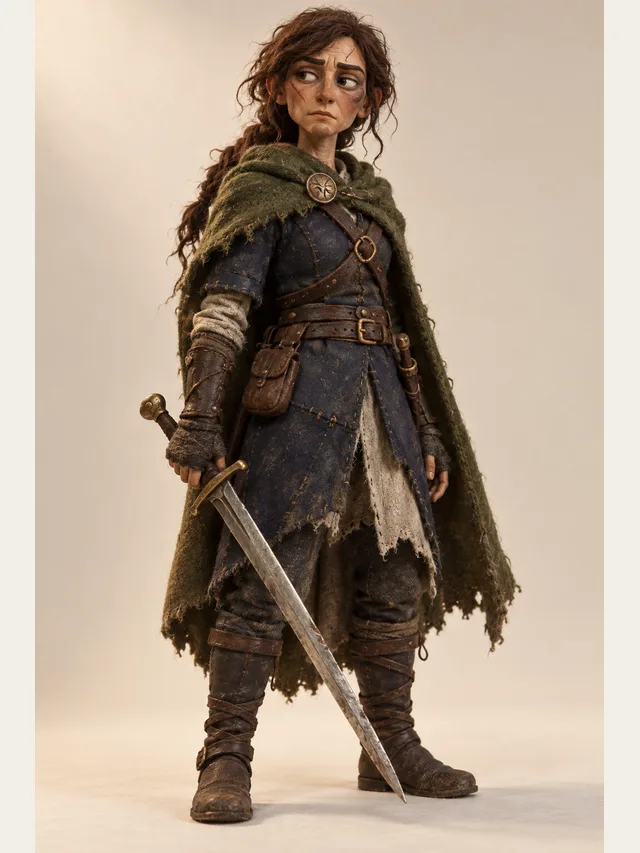
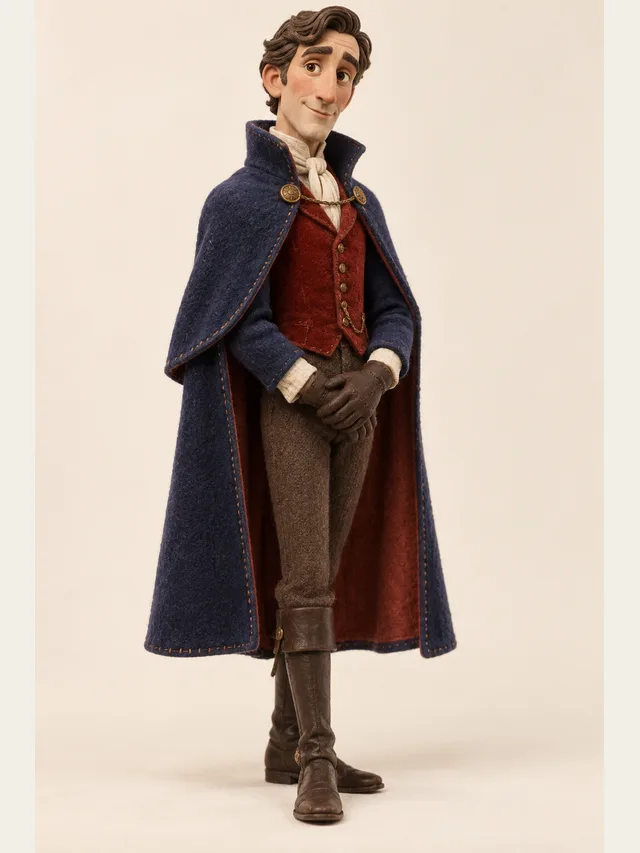
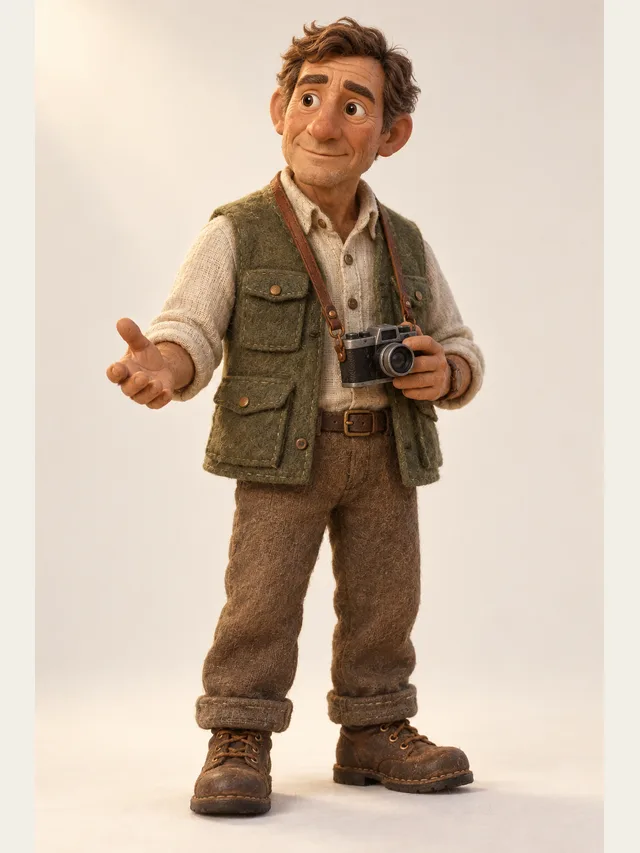
Zwei Figuren und ein Erzähler, aus einem einzigen Einfügen. Drück auf Play und sieh, wer gerade spricht.
 MARIADu wolltest um sechs hier sein.
 DANIELIch wollte es versuchen. Das ist ein Unterschied, und das weißt du.
- MARIASie hat die ganze Zeit am Fenster gewartet.
- DANIEL… Hör auf.
 ERZÄHLERDraußen fuhr der letzte Bus an der Haltestelle vorbei, ohne zu halten.
Auf einen Blick
- Was es ist
- Ein kostenloser KI-Stimmengenerator und Text-to-Speech-Werkzeug für Skripte: Es erkennt, wer spricht, gibt jeder Figur eine eigene Stimme, lässt dich die Emotion Zeile für Zeile führen und exportiert eine fertige Mischung – ein Hörspiel mit voller Besetzung statt eines Erzählers, der alle Rollen liest.
- Was du hineingibst
- Ein Skript, als Text eingefügt. Drehbuchformat, „Name: Zeile“ und gewöhnliche Prosa mit Redebegleitsätzen werden so gelesen, wie sie dastehen, ebenso die Gedankenstrich-Dialoge des Spanischen, Französischen, Portugiesischen und Russischen. Eine Zeile, die komplett in Klammern steht, gilt als Regieanweisung und wird nicht gesprochen. Einen Datei-Import gibt es nicht, füge also den Text ein, statt ein Dokument anzuhängen.
- Was herauskommt
- Eine gemischte MP3 in jedem Tarif. Ab Plus dazu SRT-Untertitel – aus deinem Skript geschrieben statt aus dem Ton transkribiert, deshalb stimmen Namen und Timings von Anfang an. Einzelspuren pro Figur, je eine Spur in voller Länge plus die Mischung, kommen als ZIP im Pro. Keinen WAV-Export.
- Figuren und Grundstimmen
- 40 Figuren in der Bibliothek, jede mit Porträt, Charakterbild und Hörprobe. Dahinter liegen 10 Grundstimmen – 4 weibliche, 5 männliche, 1 androgyne – und es sind in jeder Sprache dieselben 10. Innerhalb eines Projekts bekommen zwei Figuren nicht dieselbe Grundstimme, solange nicht alle 10 vergeben sind: Eine Szene mit bis zu 10 Sprechenden trennt sich also sauber, darüber hinaus teilen sich zwei Figuren eine Stimme und werden über Charakterbild und die Regie jeder Zeile unterschieden. Du wählst die Figur, nicht die Grundstimme. Deine eigene Stimme kannst du klonen, indem du eine kurze Einwilligungserklärung vorliest – bis zu 3 pro Konto – und sie jeder Figur geben; eine geklonte Stimme liest in allen 9 Sprachen und folgt dem Tempo, spielt aber keine Emotionen oder Regieanweisungen.
- Sprachen
- 9: English, 简体中文, 日本語, 한국어, Deutsch, Français, Español, Português, Русский. Jede Figur spielt in allen davon – eine Figur ist ein Charakterbild, keine einzelne Aufnahme – und die Sprache eines Projekts steht beim Anlegen fest. Außerhalb des Englischen bekommst du den verbreiteten Akzent der jeweiligen Sprache; regionale Akzente lassen sich nicht wählen und werden nicht zugesagt. Wir haben nicht für jede Sprache Muttersprachler alles abhören lassen, hör dir also erst deine eigenen Zeilen an, bevor du dich festlegst.
- Emotion und Regie pro Zeile
- Jede Zeile wird von einem KI-Sprecher nach einer ausgeschriebenen Regieanweisung gespielt, die 7 Emotionen (Neutral, Fröhlich, Traurig, Wütend, Angst, Flüstern, Aufgeregt) werden also gespielt und nicht mit Einstellungen nachgeahmt. Eine Grundemotion je Figur gibt es in jedem Tarif; Emotion Zeile für Zeile zu überschreiben, gibt es nur im Pro, und die 5-stufige Temporegelung (0.75×–1.25×) kommt mit Plus und Pro. Eine Zeile neu zu erzeugen, ergibt einen wirklich anderen Take bei gleicher Stimme, und wer eine Zeile ändert, lässt nur diese eine Zeile neu synthetisieren.
- Preis und offene Beta
- Ein Guthabenpunkt ist ein Zeichen Skript, und abgezogen wird nur beim Herunterladen – Erzeugen und Anhören kosten nichts, innerhalb einer Obergrenze von 30 Zeilen pro 24 Stunden im Free und bis zu 2,000 im Pro. Der Free-Tarif ist ein einmaliger Topf von 4,500 Guthaben, etwa 5 Minuten fertiges Audio, mit 2 Figuren pro Projekt. Die bezahlten Tarife kosten Basic $5, Plus $19, Pro $29 im Monat, jährlich 10% günstiger. Die Bezahlung ist noch nicht live: In der offenen Beta bekommt jedes Konto den vollen Pro-Funktionsumfang gratis, die kommerzielle Lizenz bleibt davon ausgenommen und kommt mit einem bezahlten Tarif, sobald die Tarife öffnen.
- Was noch nicht geht
- Klonen lässt sich nur die eigene Stimme, und eine geklonte Stimme liest den Text, ohne Emotionen oder Regieanweisungen zu spielen. Es gibt keinen Datei-Import, keinen WAV-Export, kein Aussprachewörterbuch, keine Tonhöhenregelung und keine Möglichkeit, eine bestimmte Grundstimme oder einen regionalen Akzent zu verlangen. In keiner Sprache gibt es echte Kinderstimmen: Kinderrollen werden von erwachsenen Sprechern gespielt, so wie der Animationsfilm es immer gehalten hat. Figuren existieren nur innerhalb eines Projekts und wandern nicht ins nächste.
Die Besetzung
40 Figuren, jede mit Gesicht, Persönlichkeit und Stimme
Tipp auf irgendjemanden. Jede Figur spielt in allen neun Sprachen – hier hörst du die Deutsch Fassung.
Was du bekommst
Alles, was das Studio kann, auf einen Blick
Automatische Besetzung aus dem Einfügen
Drehbuchformat, „Name:“-Zeilen, Prosa mit Redebegleitsätzen. CastDub findet jeden Sprecher und schlägt für jeden eine Figur aus der Bibliothek vor – keine Vorlage, die erst ausgefüllt werden muss.
Mehr erfahren →0240 Figuren mit Gesicht
Jede hat einen Namen, eine Persönlichkeit, ein Geschlecht und eine Altersgruppe. Zwei Figuren im selben Projekt teilen sich nie eine Stimme, bis der Sprache die Stimmen ausgehen.
Mehr erfahren →03Emotion und Tempo, Zeile für Zeile
Sieben Emotionen und fünf Tempi. Eine Grundemotion pro Figur gibt es in jedem Tarif; einzelne Zeilen markierst du in Pro, das Tempo änderst du in Plus und Pro.
Mehr erfahren →04Neun Sprachen, eine Besetzungsliste
Englisch, Chinesisch, Japanisch, Koreanisch, Deutsch, Französisch, Spanisch, Portugiesisch und Russisch. Jede Figur spielt in allen; die Sprache eines Projekts wird beim Anlegen festgelegt.
Mehr erfahren →05Exporte, die direkt auf die Timeline passen
Eine gemischte MP3 in jedem Tarif. Einzelspuren pro Figur in Pro. Eine SRT in Plus und Pro, die von Anfang an synchron ist, weil sie aus deinem Skript stammt und nicht aus einer Transkription.
Mehr erfahren →06Bezahlt wird der Download, nicht das Ausprobieren
Generieren und Probehören kosten nie Download-Guthaben, und wer eine Zeile ändert, lässt nur diese Zeile neu erzeugen. Der Gratis-Tarif startet mit einem einmaligen Guthaben für etwa 5 Minuten fertiges Audio.
Mehr erfahren →Vier Schritte
Einfügen → besetzen → Emotion setzen → exportieren
- Skript einfügen
Kopier den Text direkt hinein. Drehbuchformat, „Name:“-Zeilen und normale Prosa mit Redebegleitsätzen funktionieren alle – es gibt keine Vorlage, die du vorher ausfüllen musst.
- Szene besetzen lassen
CastDub findet jede sprechende Figur und schlägt für jede einen Bibliotheks-Charakter vor, passend dazu, wie das Skript sie zeigt. Hör dir Alternativen direkt hintereinander an derselben Zeile an und behalte, was sitzt.
- Emotion führen
Gib jeder Figur eine Grundlage und markiere dann – in Pro – die Zeilen, an denen sie bricht. Zurückhaltung ist es, was den Umschwung tragen lässt – führe fünf Zeilen, nicht fünfzig.
- Mix exportieren
Ein fertiger Mix als MP3 in jedem Tarif, Einzelspuren pro Figur für die Vertonung in Pro, und ab Plus eine SRT, die synchron ist, weil sie aus deinem Skript stammt und nicht aus einer Transkription.
Was andere damit machen
Wähle die Form deines Projekts
Fanfiction als Hörspiel
Dialoglastig, von Figuren getragen – das Schlimmste, was man einem einzelnen Erzähler geben kann.
Kindergeschichten
Eine warme erwachsene Erzählstimme, helle Stimmen für die Kinderrollen, und kein Kind im Aufnahmeprozess.
Kurzdrama-Synchro
Achtzig Folgen, je ein Projekt, jedes Mal dieselbe Besetzung aus der Bibliothek, und Untertitel pro Folge.
OC, VTuber und Visual Novel
Hunderte verzweigte Zeilen, jede Figur mit eigener Stimme, und Zeitcodes, um sie in Dateien zu schneiden.
Hörbuch und Hörspiel
Eine Erzählstimme für die Prosa, eine eigene Stimme für jede Figur darin.
Erstellen →
11 fertige Workflows
Preise
Kostenlos loslegen, mit einem Startguthaben zum Ausprobieren
Bezahlt wird dafür, wie viel fertiges Audio du herunterlädst, dazu für Emotion pro Zeile und Besetzungsgröße – nicht für die Stimmbibliothek. Jede Stimme gehört allen.
Free
US$0 / Monat
Hör, wie dein Skript besetzt klingt, bevor du irgendetwas bezahlst.
- Generieren und Anhören kostet kein Guthaben – bis zu 30 Zeilen pro 24 Stunden
- 4.500 Download-Guthaben einmalig (rund 5 Minuten fertiges Audio)
- Alle 40 Charakterstimmen – die Bibliothek ist nicht die Bezahlschranke
- 2 Figuren pro Projekt
- Nur private, nicht kommerzielle Nutzung
Basic
US$5 / Monat
Die ganze Stimmbibliothek öffnen und fertiges Audio mitnehmen.
- Alle 40 Charakterstimmen
- 54.000 Download-Guthaben pro Monat (rund 60 Minuten)
- 5 Figuren pro Projekt
- Kommerzielle Lizenz inklusive
Plus
US$19 / Monat
Führ das Tempo selbst: ein Geständnis langsamer, einen Streit schneller.
- 180.000 Download-Guthaben pro Monat (rund 200 Minuten)
- Tempo Zeile für Zeile steuern
- Unbegrenzt Figuren pro Projekt
- SRT-Untertitel exportieren
Pro
US$29 / Monat
Der Tarif fürs Hörspiel: jede Zeile mit eigener Emotion, jede Figur mit eigener Spur.
- 450.000 Download-Guthaben pro Monat (rund 500 Minuten)
- Emotion Zeile für Zeile steuern
- Stem-Export – eine Audiodatei pro Figur
- Alles aus Plus
Häufige Fragen
Was ist ein KI-Hörspiel-Tool?
Es nimmt ein Skript mit mehreren Sprechenden und macht daraus gespieltes Audio, mit einer anderen Stimme für jede Figur. Das ist eine andere Aufgabe als Text-to-Speech, das einen Textblock mit einer Stimme vorliest. Die eigentliche Arbeit liegt hier im Besetzen, im Führen jeder Zeile, darin, die Figuren innerhalb eines Projekts unterscheidbar und beständig zu halten, und im Export von etwas, das du weiterverarbeiten kannst.
Kann jede Figur eine eigene Stimme bekommen?
Genau darum geht es. CastDub erkennt, wer spricht, weist jeder Figur eine eigene Stimme zu und hält diese Zuweisung im ganzen Projekt stabil – dieselbe Figur klingt in der ersten Zeile wie in der dreihundertsten.
Darf ich das Audio kommerziell nutzen?
In jedem bezahlten Tarif ja – Basic, Plus und Pro enthalten eine kommerzielle Lizenz. Der Free-Tarif ist für private, nicht-kommerzielle Nutzung. Dein Skript bleibt in jedem Tarif deins.
Wie viele Figuren darf ein Projekt haben?
Zwei in Free, fünf in Basic, unbegrenzt in Plus und Pro. Die meisten Szenen von einzelnen Kreativen landen inklusive Erzähler bei drei bis sechs Sprechenden – Basic deckt damit viel ab, für Ensembles nimmst du Plus oder Pro.
Gibt es Stimmklonen, und wessen Stimme darf ich klonen?
Ja, und nur deine eigene. Du liest eine kurze Einwilligungserklärung vor – deinen Namen, das heutige Datum und dass du einverstanden bist –, und genau diese Aufnahme wird zur Stimme. Sie liest dann Zeilen in allen neun Sprachen. Sie spricht die Wörter und folgt dem Tempo der Zeile, aber Emotionen und Regieanweisungen wirken bei ihr nicht. Personen des öffentlichen Lebens, Schauspielende oder Sprechende und alle anderen Menschen klonen wir nicht, und die Stimme eines Kindes nie. Einen Klon kannst du jederzeit löschen; damit wird auch das damit erzeugte Audio gelöscht. Die vollständigen Regeln stehen in unserer Stimmklon-Richtlinie.
Welche Sprachen werden unterstützt?
Neun: Englisch, Chinesisch, Japanisch, Koreanisch, Deutsch, Französisch, Spanisch, Portugiesisch und Russisch. Jede Figur der Bibliothek spielt in allen neun – eine Figur ist eine Rolle, keine einzelne aufgenommene Stimme, dieselbe Besetzungsliste funktioniert also in jeder davon. Die Sprache eines Projekts wird beim Anlegen festgelegt und bleibt danach gleich. Die zehn Grundstimmen, auf die die Bibliothek verteilt wird, sprechen alle neun Sprachen – auf Deutsch stehen dir also genau dieselben zur Verfügung wie auf Englisch. Gesprochen wird Standarddeutsch; regionale Färbungen kannst du nicht wählen.
Kann ich Untertitel exportieren?
Ja, in Plus und Pro, und der Untertitel-Export verbraucht kein Guthaben. Weil die Untertiteldatei aus deinem Skript entsteht und nicht aus dem Audio transkribiert wird, sind Namen und erfundene Wörter richtig geschrieben und die Zeiten stimmen von Anfang an.
Gibt es einen Gratis-Tarif?
Ja. Free gibt dir zwei Figuren pro Projekt, die ganze Stimmbibliothek und ein einmaliges Guthaben von 4.500 Zeichen – rund fünf Minuten fertiges Audio, genug für eine vollständige kurze Szene und für die Entscheidung, ob das Werkzeug zu deiner Arbeitsweise passt. Es ist ein Guthaben zum Ausprobieren, kein Monatskontingent: Ist es aufgebraucht, füllt nur ein bezahlter Tarif es wieder auf.
Einwilligung und Ethik
Wessen Stimme du benutzen darfst
Eine geklonte Stimme braucht die aufgenommene Einwilligung der Person
Geklont werden kann eine Stimme nur aus einer einzigen Aufnahme: der Person selbst, wie sie eine Einwilligungserklärung vorliest – ihren Namen, das Datum und dass sie einverstanden ist. Diese Aufnahme ist die Stimme. Ohne Einwilligungsnachweis gibt es also keinen Klon, und niemand kann aus einem Mitschnitt, in dem jemand spricht, dessen Stimme klonen.
Wir klonen keine Personen des öffentlichen Lebens und keine Schauspieler
Nicht als Parodie, nicht für Forschung, auch nicht mit Hinweis. Eine synthetische Aufnahme einer erkennbaren Person ist von einer echten nicht zu unterscheiden, sobald sie das Projekt verlässt, und es gibt keine Rahmung, die das sicher macht. Konten, die es versuchen, werden geschlossen werden.
Die Stimme eines Kindes klonen wir nie
Es gibt keinen Tarif, keine Vereinbarung und keine elterliche Erlaubnis, die das freischalten wird. Die Kinderfiguren in der Bibliothek sind synthetische Stimmen, und bei nichts, was du hier machst, wird ein Kind aufgenommen – in keiner der neun Sprachen gibt es eine Kinderstimme, Kinderrollen werden durchweg von erwachsenen Stimmen gespielt, Jungenrollen oft von einer weiblichen, so wie im Zeichentrick seit jeher.
Sag dazu, wenn Audio erzeugt ist
Wir können das nicht durchsetzen, und wir sagen es trotzdem: Publikum reagiert gut auf offengelegtes synthetisches Audio und sehr schlecht darauf, es hinterher herauszufinden. Es kostet eine Zeile in der Beschreibung.
Besetze heute Abend deine erste Szene
Füge ein Skript ein, lass CastDub jeder Figur eine Stimme geben und exportier ein fertiges Hörspiel.
Kostenlos startenKeine Kreditkarte. Free gibt dir ein einmaliges Guthaben.