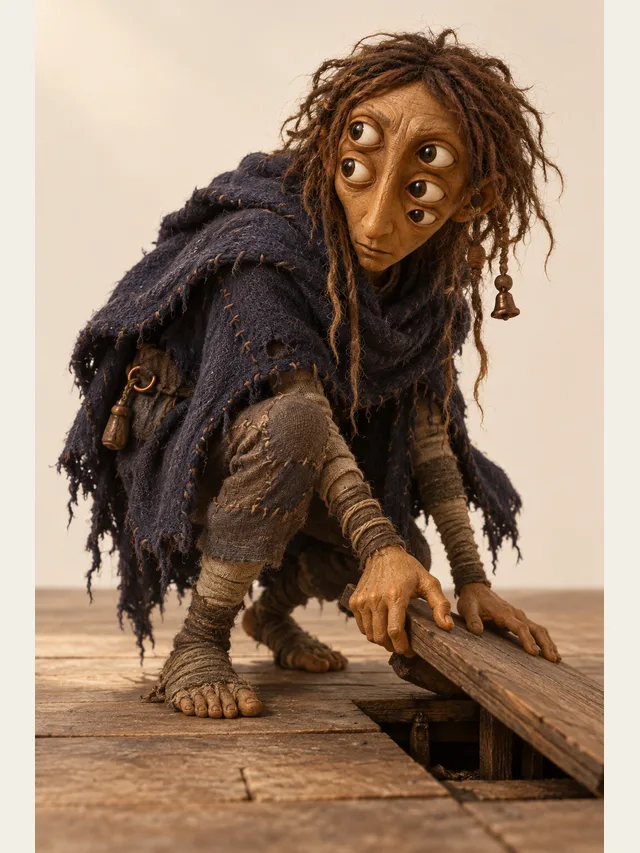
Morrow
Algo bajo el piso que aprendió tu nombre
Categoría de voz
El terror en audio no es cuestión de volumen. Es una voz ligeramente equivocada: demasiado calmada, demasiado cerca, un tiempo más lenta de lo que sería una persona. CastDub te da esas voces y el control por línea para poner lo equivocado exactamente donde la escena lo necesita.
Morrow
Algo bajo el piso que aprendió tu nombre
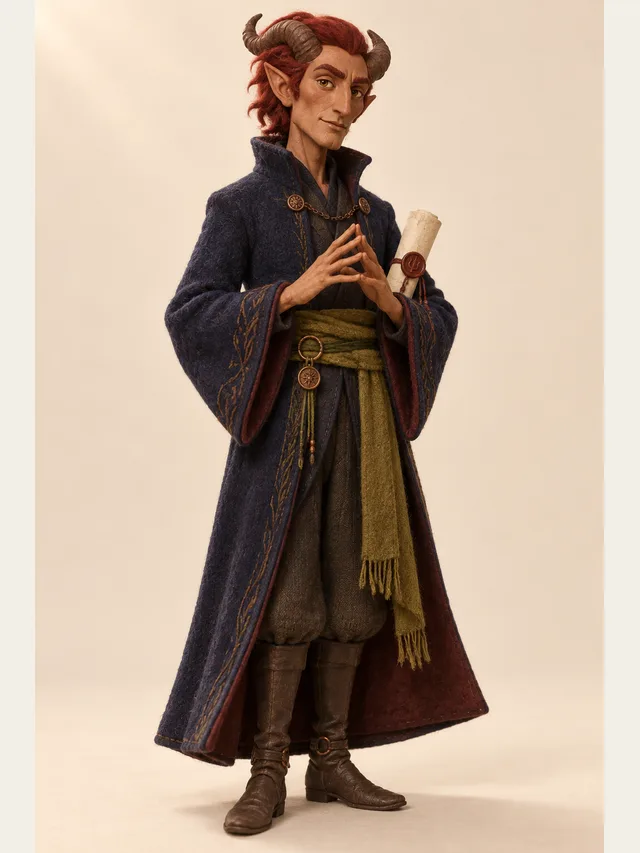
Vex
Negocia en un tono perfectamente razonable
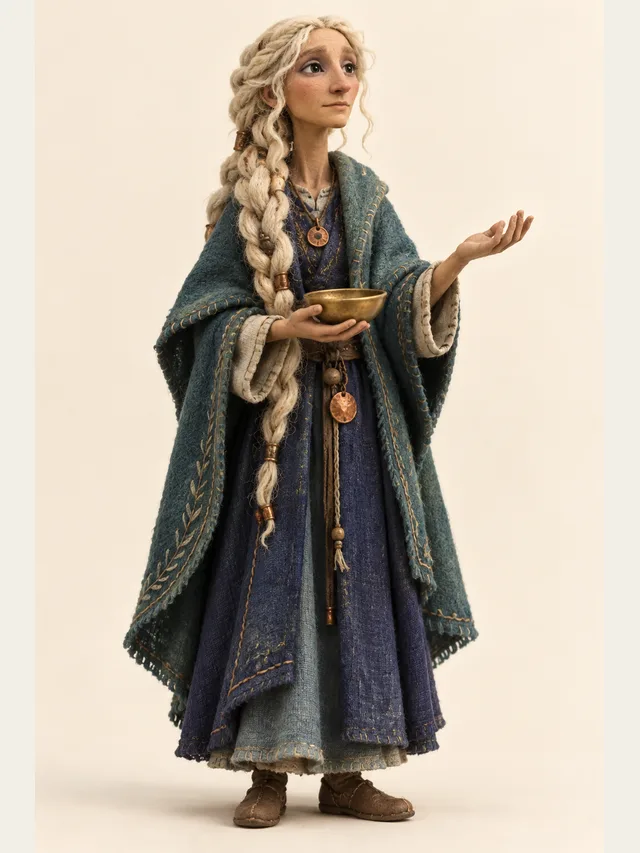
Delphi
Contesta la pregunta que deberías haber hecho
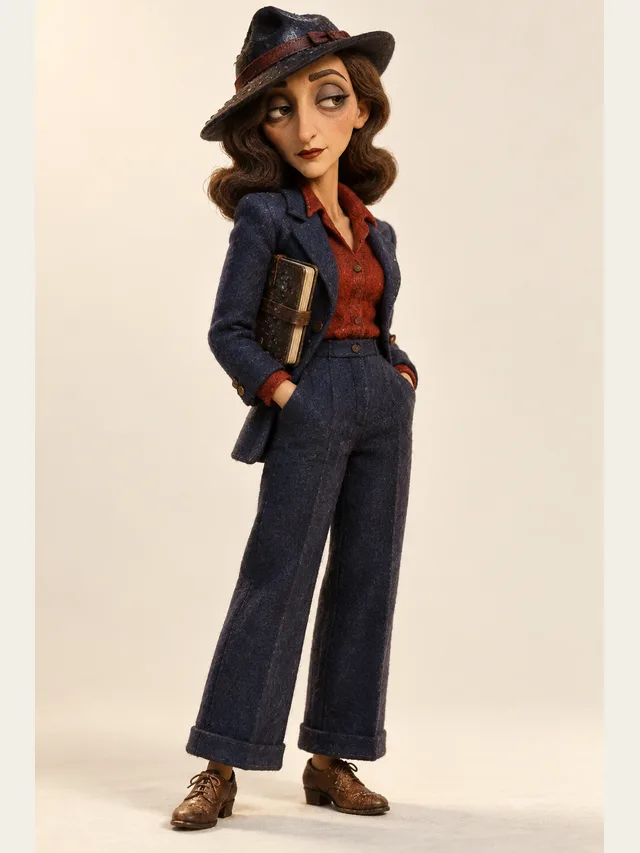
Sable
Narra sus propias malas decisiones
Las muestras son provisionales mientras se produce el audio de demostración público. Todas las voces están en todos los planes: la biblioteca no es el muro de pago.
En el cine el público ve la amenaza y la tensión viene de anticipar lo que va a hacer. En audio el público nunca la ve, y la tensión viene de no saber qué es. Eso cambia lo que tiene que hacer una voz. Un monstruo visual puede rugir porque lo estamos viendo; un monstruo de audio que ruge acaba de avisar que es un monstruo, y la escena se desinfla.
La técnica clásica del radioteatro es mantener la voz amenazante dentro del rango humano y volverla equivocada en un solo punto concreto: demasiado cerca del micrófono, demasiado sin prisa, contestando una pregunta que nadie hizo. Una sola cosa mal supera a cinco efectos, porque la imaginación de quien escucha hace el resto y es mejor en esto que tú.
Cualquiera con experiencia en terror sonoro te va a decir lo mismo: el miedo lo llevan los huecos. Tres segundos de silencio después de una línea pegan más fuerte que cualquier sonido que pudieras poner ahí, porque quien escucha se inclina hacia adelante, y ese es el estado en el que lo quieres.
En la práctica esto significa escribir la puntuación a propósito y partir líneas para crear pausas en vez de confiar en que el renderizado adivine. CastDub trata cada línea como una interpretación separada con un hueco en medio, así que tus saltos de línea son tu control de tiempo. Úsalos.
Un patrón que funciona de manera fiable: empieza con dos personas teniendo una conversación corriente, introduce una línea ligeramente desajustada, deja que la conversación corriente siga como si nada, y después deja que lo desajustado se repita. La escalada es estructural, no vocal: las voces casi no cambian, pero cambia cómo las lee quien escucha.
Dirige esto dejando casi todo en neutro. Si marcas doce líneas como aterradoras, ninguna lo es. Marca una, y las once de alrededor se vuelven aterradoras por asociación.
La ficción de terror es explícitamente bienvenida aquí, incluida la desagradable. Los límites son sobre personas reales, no sobre intensidad. No generes una voz clonada de una persona real diciendo cosas amenazantes. No produzcas audio dirigido a asustar a alguien en concreto. No uses la herramienta para fabricar una grabación de alguien.
Esto no es delicadeza con el género. Es la diferencia entre una ficción y un arma, y es una línea que el propio género siempre ha respetado.
Redacta la escena sin un solo grito. Si da miedo a volumen de conversación, va a ser demoledora en cuanto le agregues una línea levantada.
Elige una voz cuya calma no empate con lo que está diciendo. La amenaza viene del desajuste: una voz agradable describiendo algo atroz es peor que un gruñido.
Marca líneas sueltas como susurradas en vez de susurrar la escena entera. Un susurro solo se lee como íntimo y amenazante cuando está rodeado de habla normal.
Las pausas son el instrumento. Pon puntos donde quieras que quien escucha espere, y parte líneas para crear huecos. El silencio es el único efecto de terror que ningún modelo de voz puede arruinar.
Exporta las pistas separadas en Pro y coloca la voz amenazante ligeramente fuera del centro. El terror en audio es un formato de auriculares: revísalo como lo va a oír tu público.
Volver a generar una línea sin cambios te da el mismo audio, así que el clásico efecto doblado sale del editor: duplica la línea, desplaza o cambia el tono de la copia y superpón las dos. A propósito no horneamos distorsión pesada dentro del renderizado: la distorsión es una decisión de mezcla, y hornearla vuelve imposible deshacerla.
Porque un grito le dice a quien escucha dónde está el peligro y qué tan grave es. Una voz calmada le niega las dos cosas, y quien escucha llena el hueco con algo peor de lo que tú podrías haber escrito. Es la regla más vieja del radioteatro de terror y es anterior a todas las herramientas involucradas.
No dentro del renderizado. Eso es reverberación y filtrado, y va en tu editor sobre la pista exportada. Genera la interpretación limpia y trátala después: una toma limpia se puede alejar, pero una toma tratada no se puede limpiar.
La ficción está bien, incluida la ficción violenta. Lo que no se permite es audio diseñado para hostigar a una persona real, amenazas dirigidas a alguien identificable, o voces clonadas usadas para que parezca que alguien dijo algo que no dijo. Esos usos cierran cuentas.
Menos de las que crees. Buena parte del audio de terror son dos voces y un narrador, porque el aislamiento es parte del género. El límite de dos personajes del plan gratuito cubre una cantidad sorprendente de eso.
Sí, en cualquier plan de pago. Basic le queda a un episodio semanal; Pro vale la pena si quieres pistas separadas, porque la mezcla de terror depende casi por completo de colocar las voces en el espacio.
Pega un guion, deja que CastDub le dé una voz propia a cada personaje y exporta un audiodrama terminado.
Empieza gratisSin tarjeta. Free te da una bolsa única de créditos.